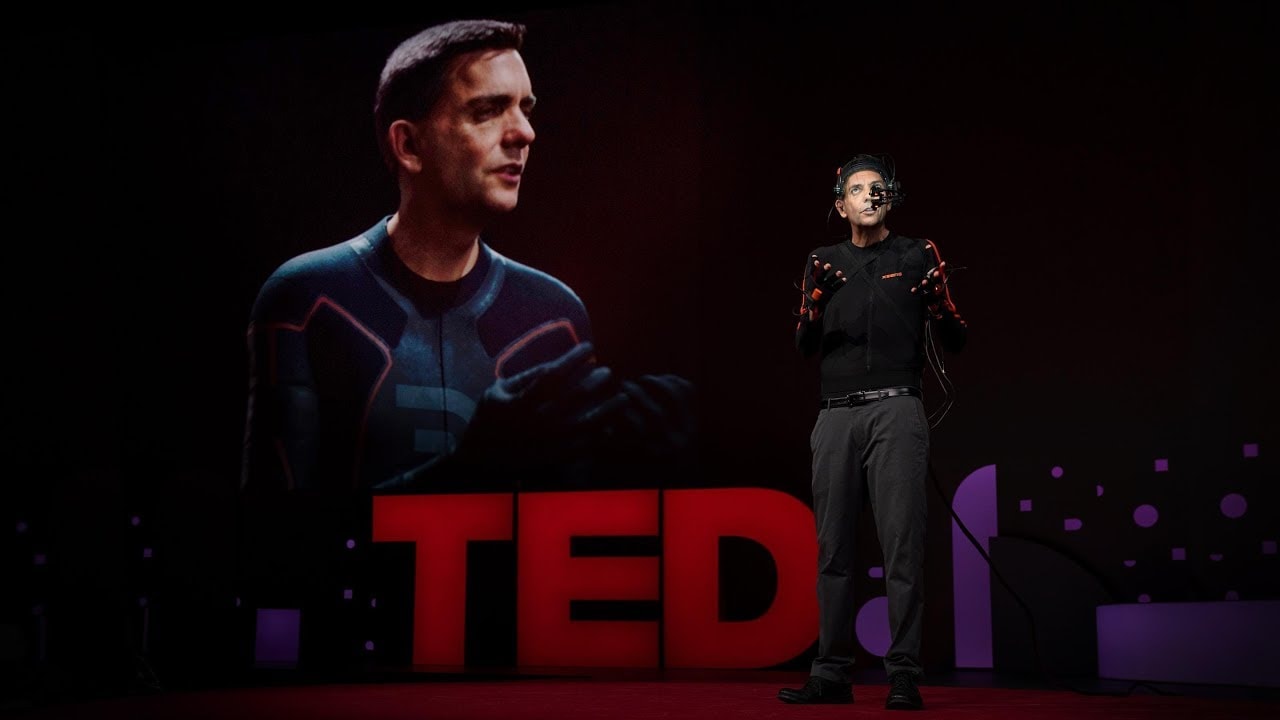
Ландшафт технологий захвата движений (performance capture) переживает драматическую трансформацию. Современные передовые методы требуют, чтобы актёры носили обтягивающие костюмы со светоотражающими маркерами, шлемы с камерами и проходили длительную постобработку. Однако следующее поколение технологий не отменяет эти методы, а дополняет их новыми возможностями.
По словам Дага Робла (Doug Roble), директора по разработке программного обеспечения в студии Digital Domain, три крупных прорыва стремительно приближаются и заметно расширят инструментарий оживления цифровых персонажей — не заменяя проверенные подходы, а открывая сценарии, где они не нужны.
Передача выступления в реальном времени
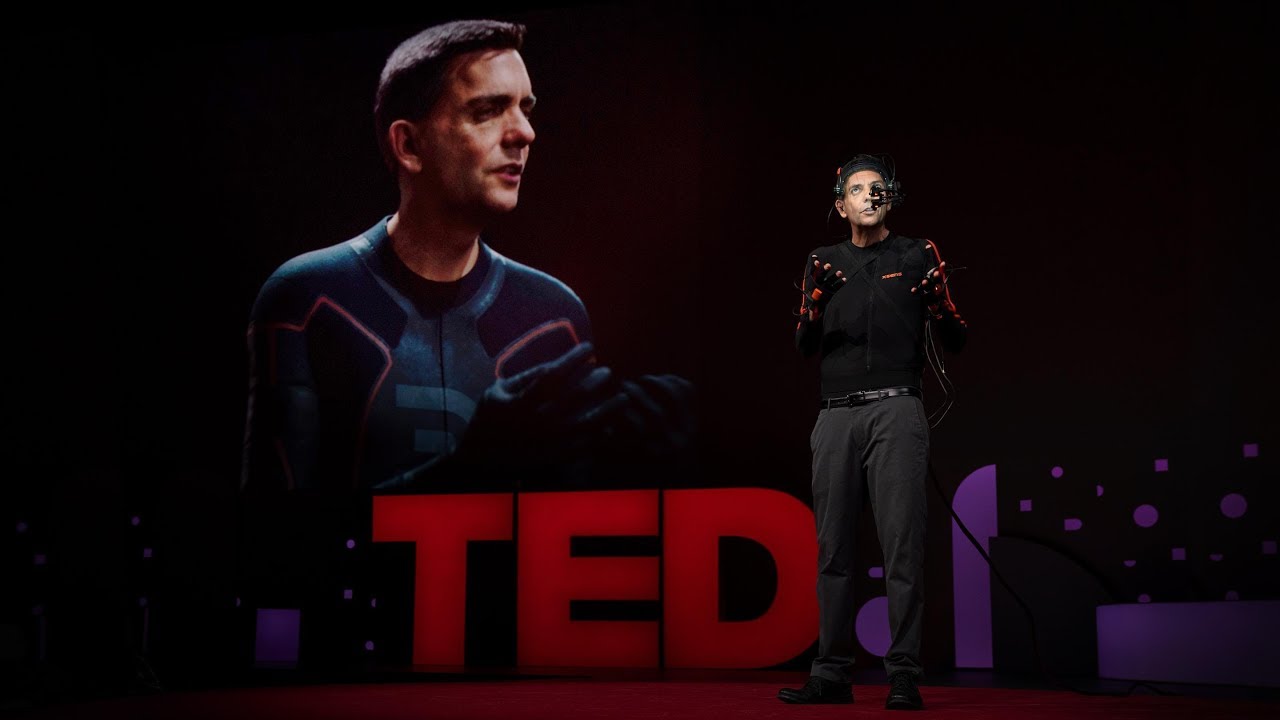
Первый прорыв — это достижение захвата движений в реальном времени, когда актёрское исполнение переносится на цифрового персонажа практически мгновенно. Это серьёзный шаг вперёд по сравнению с традиционным рабочим процессом, который занимает дни или недели обработки.
Digital Domain, имеющая богатую историю в области захвата движений, включая такие проекты, как «Загадочная история Бенджамина Баттона», «Трон», «Малефисента» и «Красавица и чудовище», находится на передовой этих исследований. Робл отмечает, что они с коллегой Дарреном Хендлером (Darren Hendler) последний год задавались вопросом: смогут ли они сделать технологию настолько точной, чтобы «стало трудно отличить актёра от его цифрового двойника».
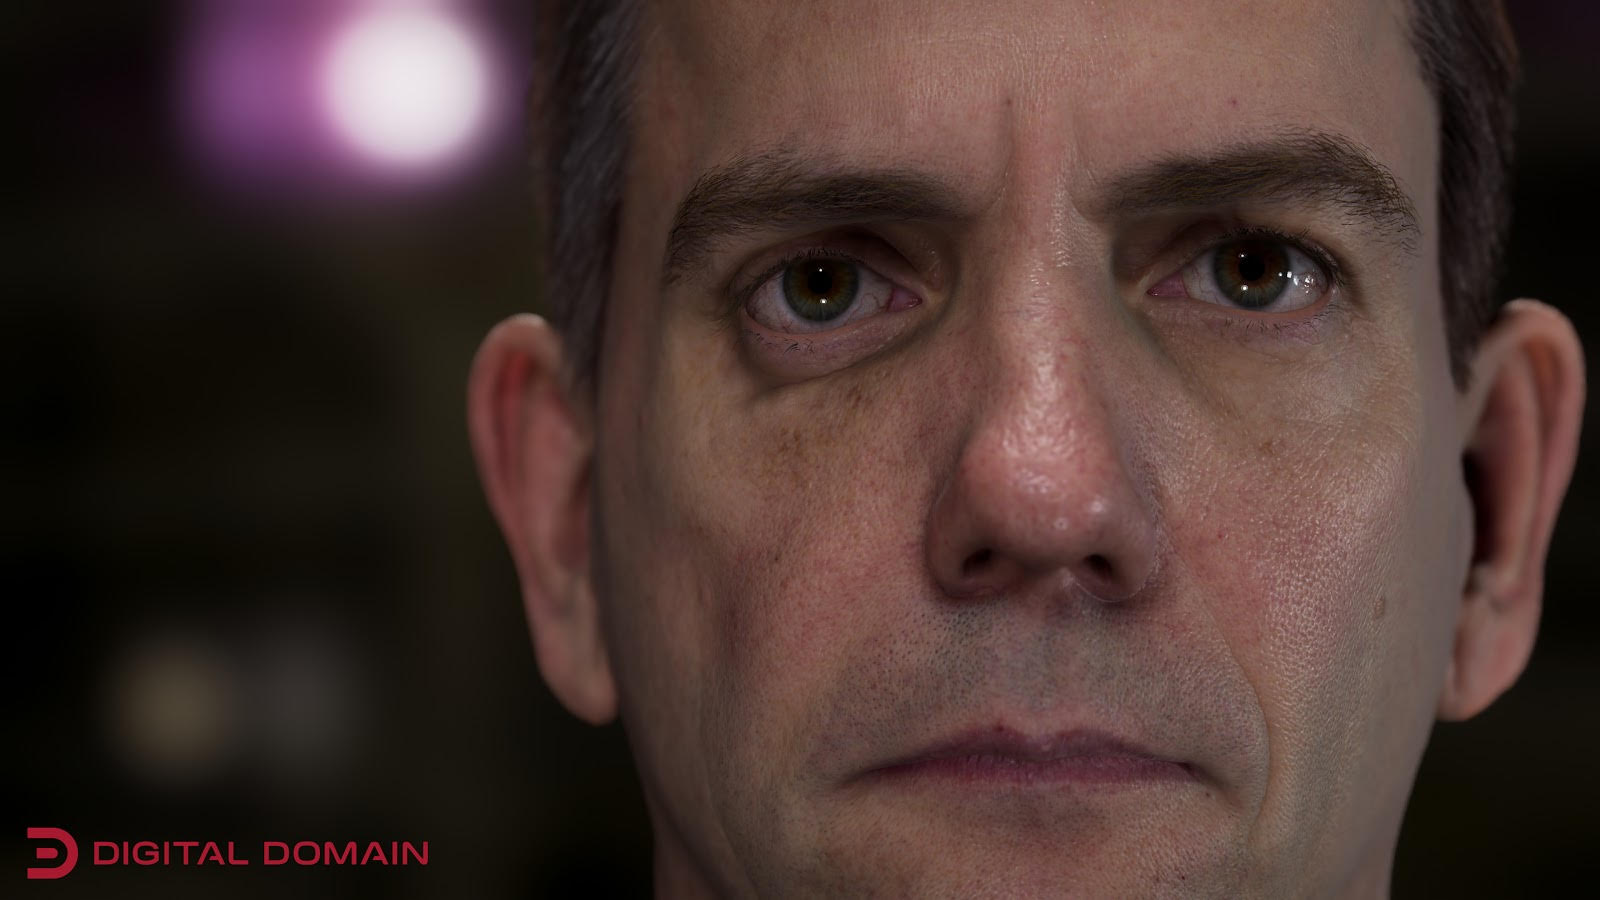
Совместная работа с Epic Games, 3Lateral и Cubic Motion дала впечатляющие результаты. В одной из демонстраций зрители увидели цифрового человека по имени Саймон — его создали путём сканирования лица с высочайшим разрешением, вплоть до измерения тока крови при различных выражениях. Система использует методы машинного обучения, чтобы понимать, как именно движется лицо.
Особенно показательным было сравнение Энди Серкиса, выполняющего роль, и его цифрового двойника — оба изображения на экране были полностью цифровыми, что наглядно демонстрирует, как далеко продвинулась технология. Примечательно, что в этой демонстрации маркеры на лице не требовались, и всё происходило в реальном времени — это стало возможным благодаря всё более мощным видеокартам и инновационным алгоритмам.
Бесмаркерный трекинг как дополнение
Второе направление — бесмаркерный трекинг, который позволяет отслеживать движение без физической атрибутики традиционного захвата: точек, нашлемных камер и обтягивающих костюмов. Исследователи из Университета Карнеги-Меллона ведут новаторские работы в этой области, которые Робл называет «совершенно новыми, только что с пылу с жару».
Их система может отслеживать скелет, лицо и даже пальцы человека с помощью всего одной камеры, причём объект не носит никакого специального снаряжения.
Представьте, что мы переносим это на киносъёмочные площадки: просто камера снимает вас, и мы можем заменить вас на что угодно.
Важно понимать, что это не отменяет маркерные технологии. Костюмы с маркерами и нашлемные камеры остаются отраслевым стандартом там, где нужна максимальная точность и контроль: в сложных сценах, при работе с несколькими актёрами одновременно и в производственных процессах, где важна предсказуемость результата. Бесмаркерный подход открывает новые сценарии — например, съёмку без подготовки актёра или работу с материалом, где надеть костюм невозможно. Оба подхода дополняют друг друга, и выбор зависит от конкретной задачи.
Машинное обучение — двигатель революции
В основе всех этих достижений лежит машинное обучение — та же технология, которая стоит за поисковыми системами Google и алгоритмами Facebook. Робл даёт простое объяснение того, как это работает в контексте визуальных эффектов.
Вместо сложных физических расчётов движения крови, сокращения мышц и натяжения кожи исследователи снимают лицо актёра тысячи раз во всех возможных выражениях. Алгоритм «обучают», показывая ему пары изображений: исходное лицо и соответствующий ему цифровой образ. Алгоритм учится распознавать закономерности: если лицо на изображении движется определённым образом, цифровой персонаж должен выглядеть соответствующим образом.
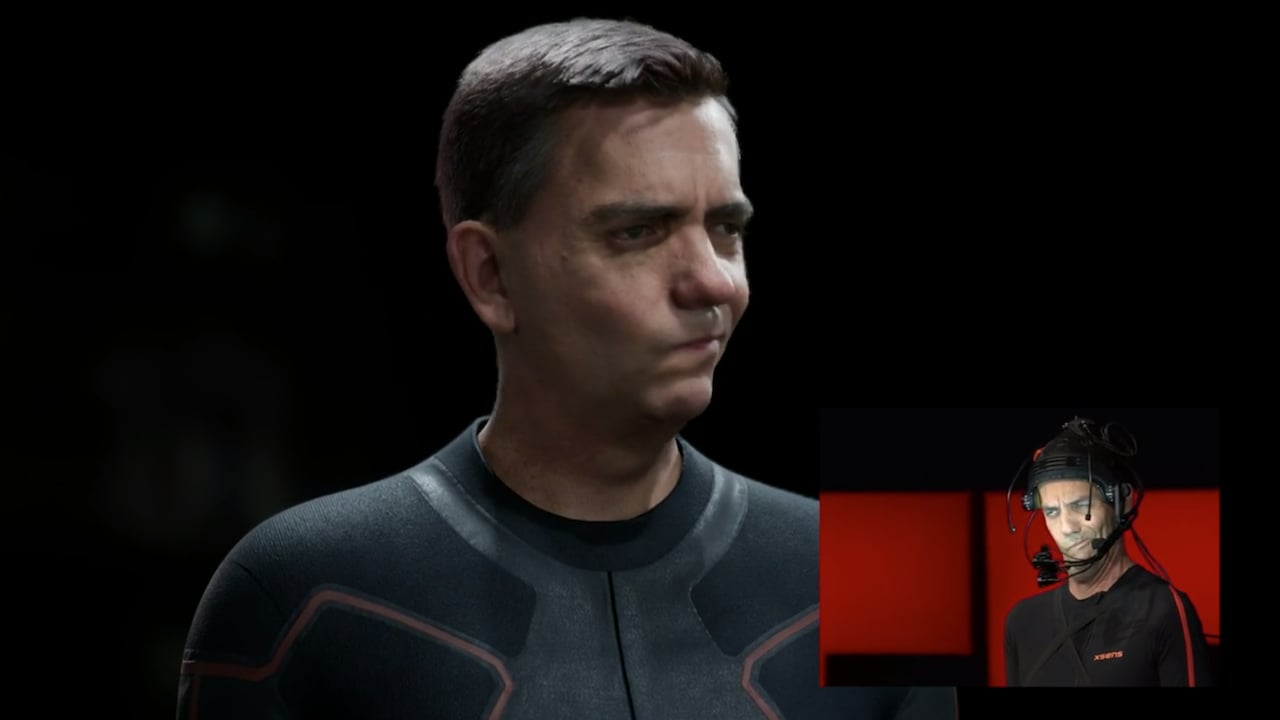
После обработки миллионов примеров алгоритм способен взять произвольное изображение человека и точно воспроизвести его выражение лица. Этот подход, который Робл кратко определяет как «показывать алгоритму картинки и говорить, как должно выглядеть лицо, пока он не научится делать это сам», теперь применяется в визуальных эффектах.
Машинное обучение в визуальных эффектах — это не замена аниматора, а новый инструмент. Алгоритм учится на реальных данных актёра и переносит его мимику на цифрового персонажа, но творческие решения по-прежнему остаются за человеком.
Передовая демонстрация: передача лица в реальном времени
Самый захватывающий пример — это передача мимики в реальном времени с использованием минимального объёма данных. В одном эксперименте Робл снял Вики и Даррена перед белой доской, когда они рассказывали истории в течение всего двух минут — этого хватило, чтобы зафиксировать разнообразные выражения лиц.
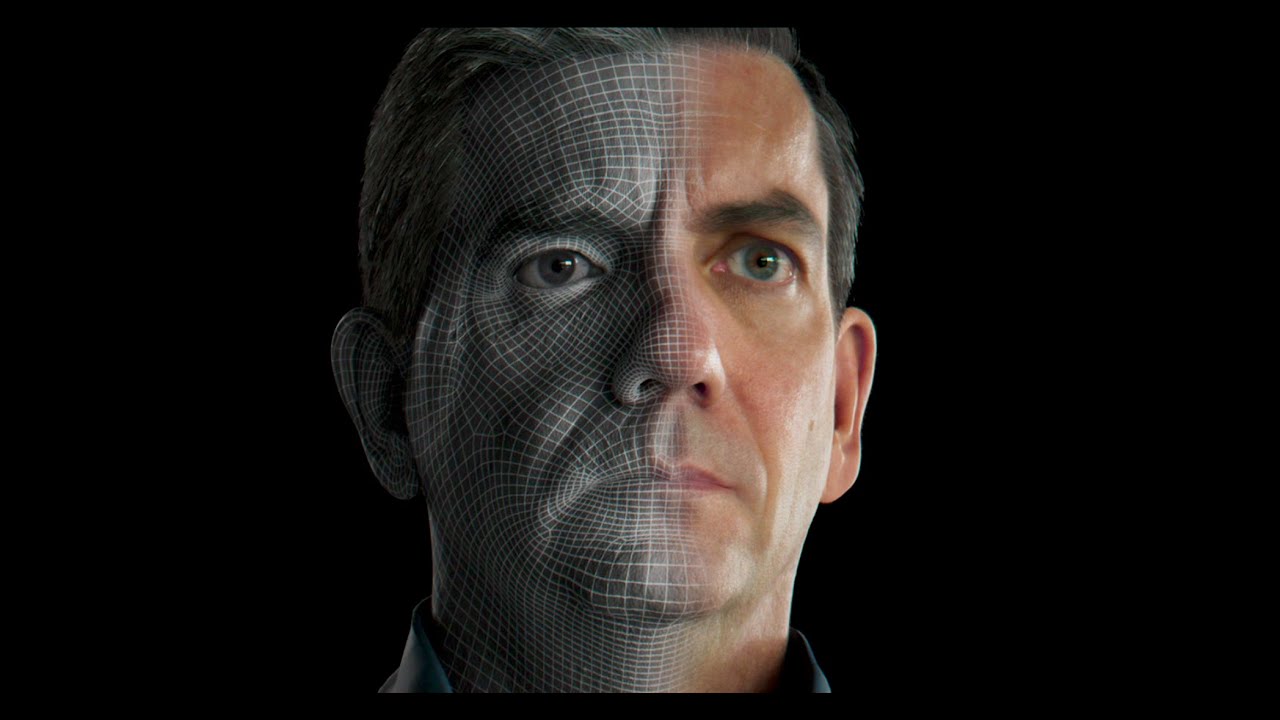
Эти кадры использовали для обучения системы. Теперь, когда камера видит лицо Вики, компьютер воспроизводит лицо Даррена с теми же выражениями. Результат фотореалистичен и не требует участия аниматоров или промежуточной обработки.
Как с восторгом заключает Робл: «Это фотореалистично, ничего между ними нет, ни аниматоров, ни обработки — всё происходит в реальном времени».
Что это значит для индустрии
Соединение обработки в реальном времени, бесмаркерного трекинга и машинного обучения обещает заметно расширить возможности технологии захвата движений. Эти технологии ещё не готовы для широкого применения, но они развиваются стремительно.
Для кинематографистов, актёров и специалистов по визуальным эффектам последствия значимы: появляются новые сценарии и упрощаются отдельные производственные процессы, а вместе с тем сохраняется проверенный инструментарий, который продолжает использоваться там, где он даёт наилучший результат. Будущее — не в отказе от привычных методов, а в разумном сочетании старого и нового.
- Три прорыва расширяют индустрию: захват в реальном времени, бесмаркерный трекинг и машинное обучение.
- Digital Domain уже переносит игру актёра на цифрового персонажа практически мгновенно — в отдельных сценариях без маркеров и постобработки.
- Исследователи из Карнеги-Меллона отслеживают скелет, лицо и пальцы одной камерой, без специального снаряжения.
- Маркерные костюмы и нашлемные камеры остаются стандартом там, где нужна максимальная точность и контроль.
- Машинное обучение учится на парах «исходное лицо — цифровой образ» и после миллионов примеров воспроизводит мимику произвольного человека.
- Для обучения системы достаточно двух минут отснятого материала — результат фотореалистичен и работает в реальном времени.
Будущее захвата движений наступает — и оно обещает быть поистине революционным.
По материалам презентации «Ближайшее будущее захвата движений» Дага Робла, директора по разработке ПО в студии Digital Domain.