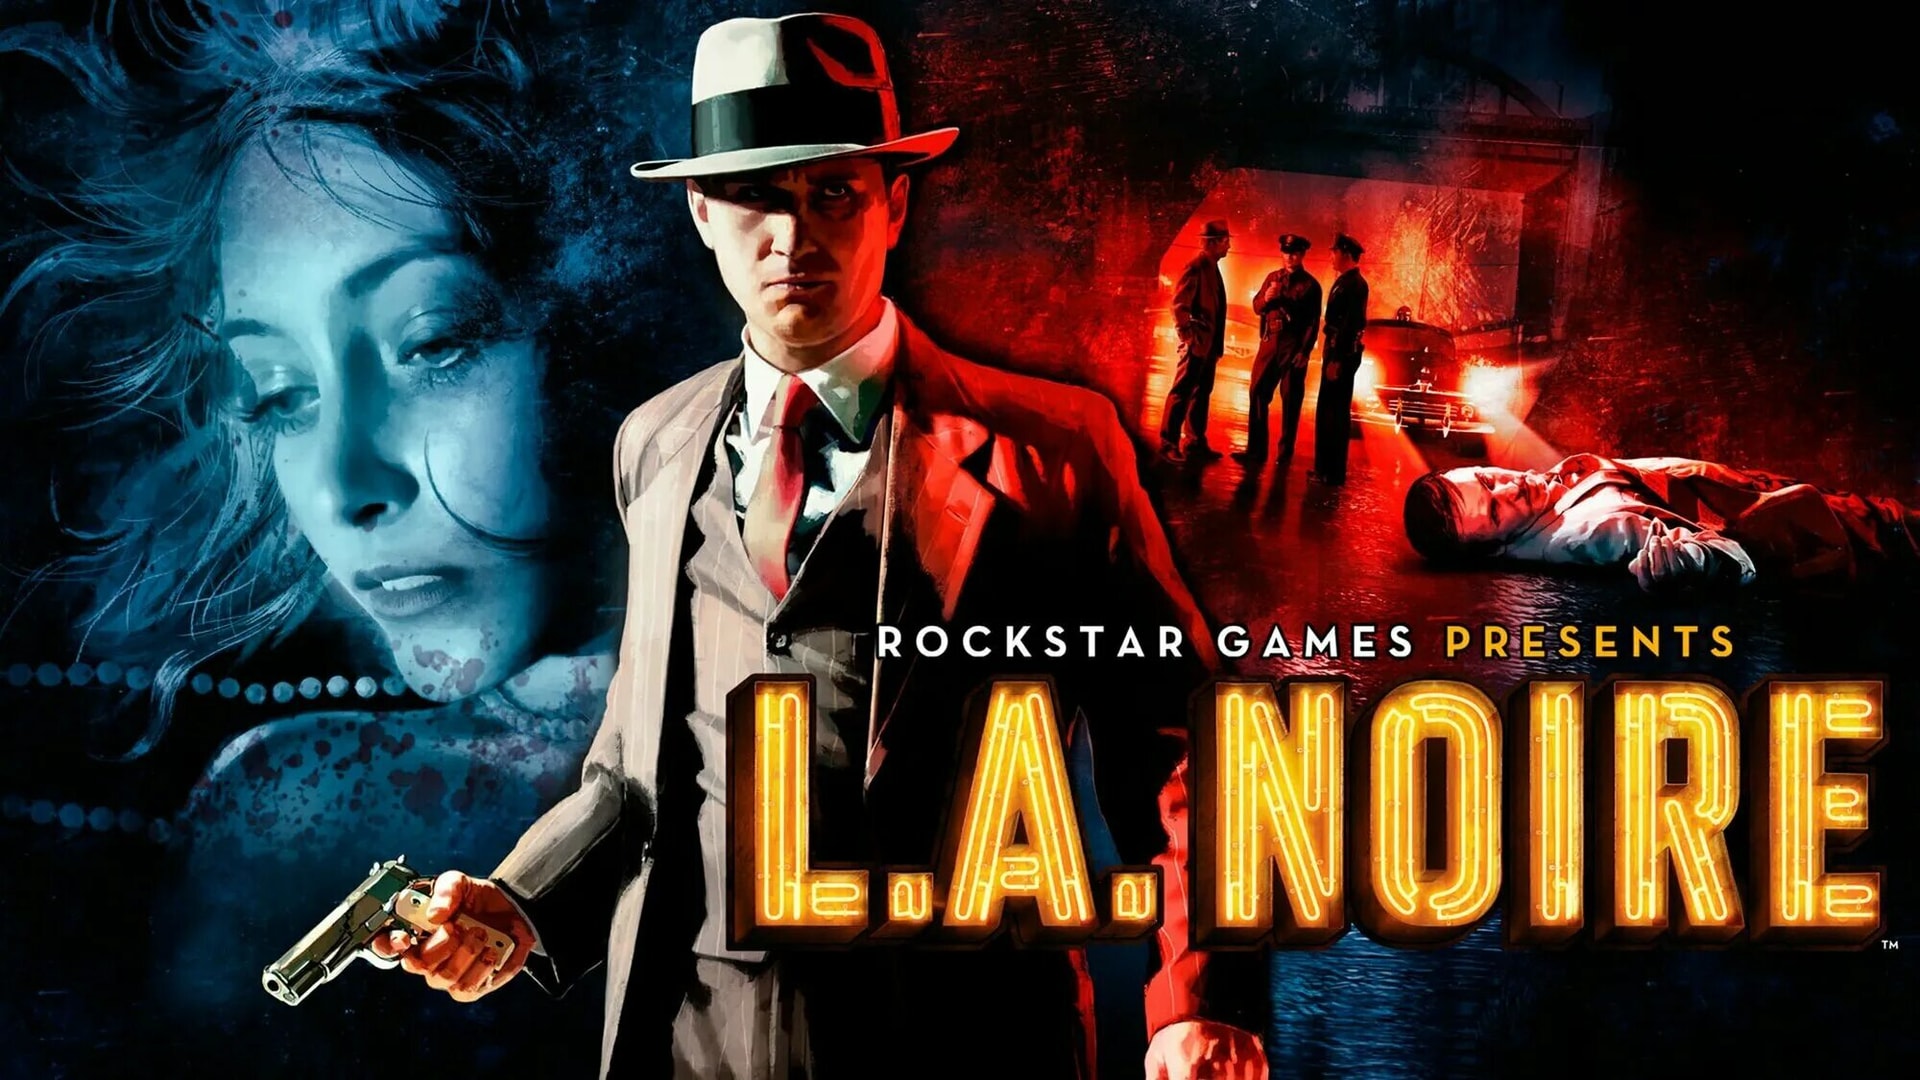
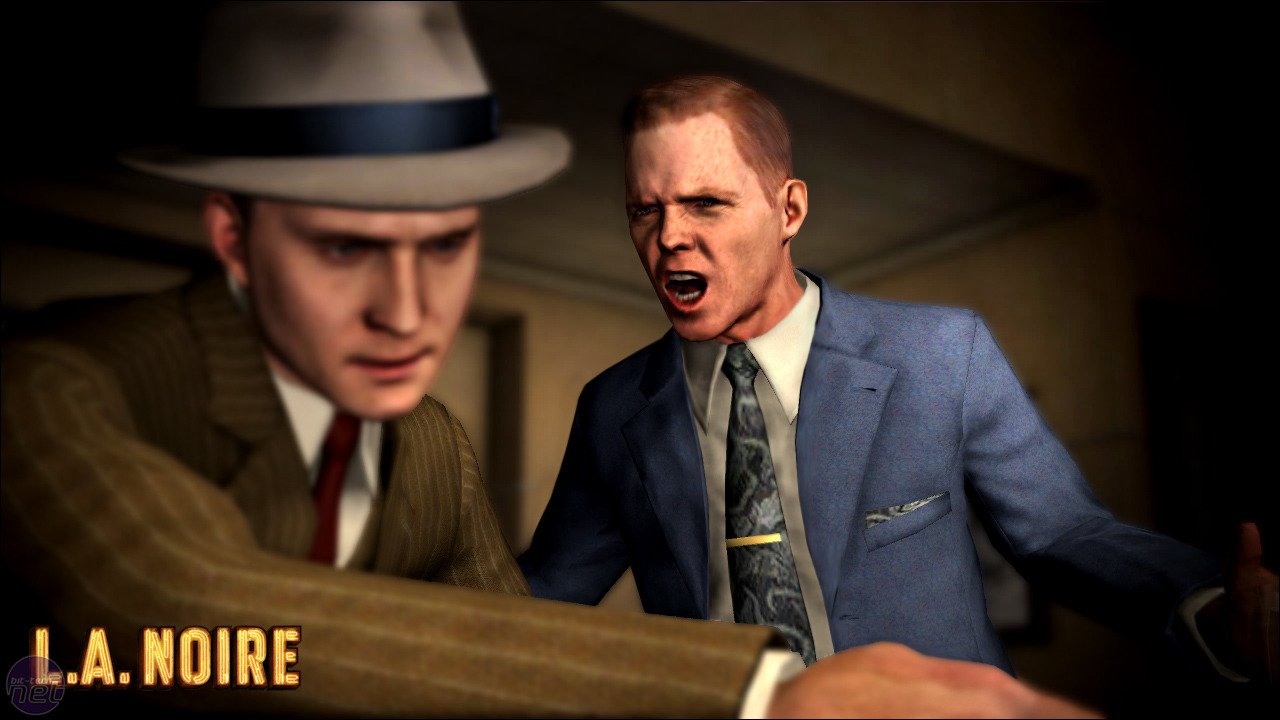
В 2011 году студия Team Bondi и издатель Rockstar Games выпустили L.A. Noire — детективный нуар, который вспоминают не за сюжет и не за открытый мир. Его помнят за лица. Беспрецедентно живые, фотореалистичные лица, по которым можно было считывать микровыражения — морщины, подёргивание губ, асимметрию, — которые раньше в реальном времени просто не воспроизводились.
За этим стояла технология MotionScan, разработанная компанией Depth Analysis. В отличие от классического маркерного захвата, она воспроизводила не только движение, но и саму текстуру кожи в 3D. Для технически подкованной аудитории это один из самых интересных кейсов в истории mocap: подход оказался одновременно прорывным и тупиковым. Разберём, как он устроен и почему индустрия от него отказалась.
Почему классический mocap не справляется с лицом
Чтобы понять, что именно перевернул MotionScan, стоит вспомнить, как устроен обычный захват движения. Классический mocap делится на несколько типов.
| Тип | Принцип | Сильные стороны | Ограничения |
|---|---|---|---|
| Оптический пассивный | Светоотражающие маркеры, камеры с ИК-подсветкой (Vicon, OptiTrack, Qualisys) | Высокая точность, субмиллиметровая | Нужна студия, окклюзии маркеров |
| Оптический активный | Светодиодные маркеры с уникальной частотой мигания | Надёжная идентификация маркеров | Дорогое оборудование |
| Инерциальный | IMU-датчики (акселерометры, гироскопы, магнитометры) на костюме | Нет окклюзий, работает где угодно | Дрейф, меньшая точность |
| Маркерный захват лица | 80–150 мелких маркеров на лице, камеры с близкого расстояния | Приемлемый результат для тела | Дискретные точки, а не поверхность |
Для тела такой подход работает хорошо. Для лица — принципиально ограничен. Маркеры дают дискретные точки, а не непрерывную поверхность, поэтому микровыражения теряются. Текстура кожи вообще не захватывается — её приходится сканировать и текстурировать отдельно, часто вручную. А ретаргетинг на риг-систему (блендшейпы или деформеры) неизбежно вносит ту самую «кукольность», по которой сразу видно компьютерную графику.
L.A. Noire поставила задачу иначе: захватить лицо целиком, как объёмное видео, с фотореалистичной детализацией и без ручной доводки.
Сферический риг из 32 камер
Depth Analysis построила специальную установку — сферический риг из 32 камер (по разным данным, от 30 до 32), расположенных вокруг головы актёра. Камеры были синхронизированы с точностью до кадра и снимали с разрешением порядка 720p при 30 кадрах в секунду (в некоторых источниках — 60 fps для повышения точности).
Ключевая деталь: это были обычные RGB-камеры видимого спектра, а не инфракрасные. Никаких маркеров на лице не было.
Актёр сидел неподвижно, голова фиксировалась подголовником, чтобы минимизировать глобальное движение. Задача — только мимика, без наклонов и поворотов головы. Это принципиально отличает MotionScan от современных систем вроде MetaHuman Animator, которые допускают свободное движение.
Каждая камера снимала с немного разного ракурса, создавая плотное стереопокрытие. По сути, это классическая мультивидеостереосъёмка (multi-view stereo, MVS) в реальном времени.
Как из 32 видеопотоков собиралось лицо
Для каждого кадра из 32 видеопотоков система Depth Analysis выполняла цепочку вычислений.
Калибровка камер. Точное определение внешних и внутренних параметров каждой камеры — позиция, ориентация, фокусное расстояние, дисторсия. Без этого MVS невозможна в принципе.
Оценка глубины. Методом multi-view stereo для каждого пикселя на опорной камере искалась соответствующая точка на соседних ракурсах, а по параллаксу вычислялась глубина. Использовались алгоритмы, похожие на PatchMatch Stereo или Semi-Global Matching, адаптированные для кожи — учитывалась её отражательная способность и подповерхностное рассеяние.
Построение 3D-меша. Из карты глубины генерировалась полигональная сетка лица для каждого кадра. Топология менялась от кадра к кадру, поэтому меш не был единым для всей анимации — это был поток геометрии.
Текстурирование. На полученный меш проецировались изображения с камер — для каждого полигона выбирался наилучший ракурс. Так создавалась фотореалистичная текстура с учётом освещения на момент съёмки.
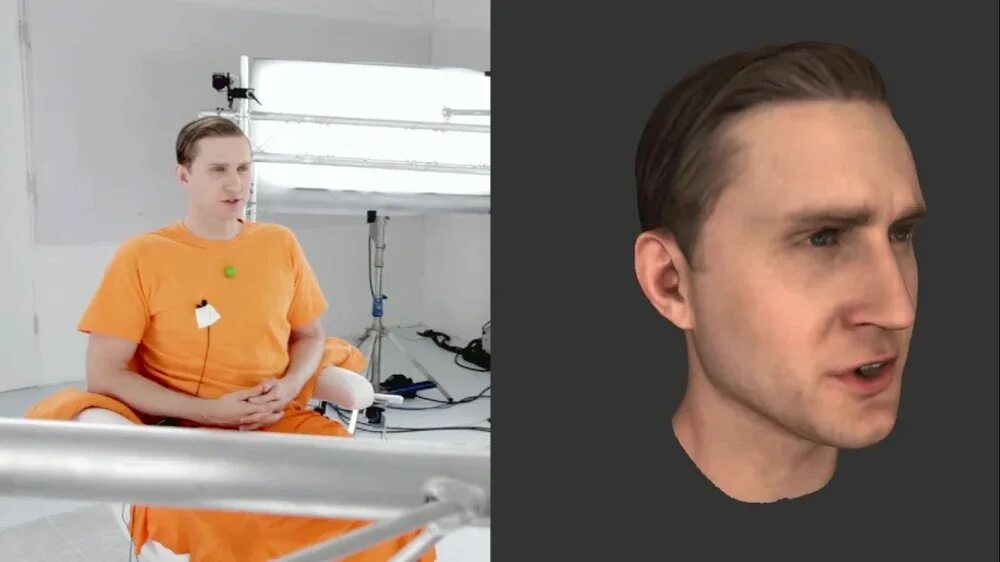
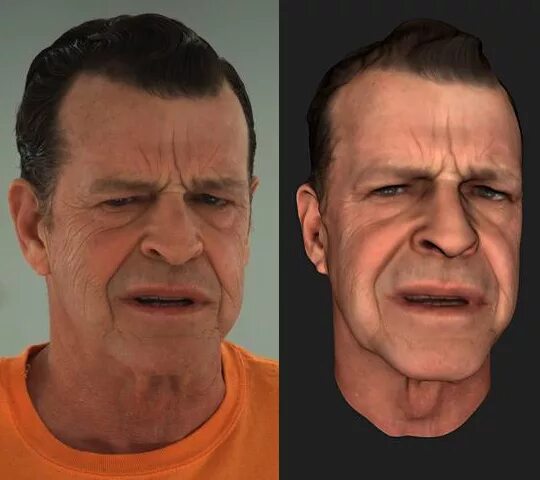
Результат — последовательность 3D-моделей лица с видеотекстурой, то есть по сути объёмное видео. Никаких блендшейпов, никакого ретаргетинга на риг — анимация лица была «как снята».
Главный технический вызов — терабайты
Одна секунда захвата лица в MotionScan могла занимать от 100 МБ до нескольких гигабайт в сыром виде: 32 видеопотока плюс геометрия плюс текстуры. Для игры с примерно двадцатью часами диалогов это сотни терабайт.
Решение включало несколько приёмов.
Регион интереса (ROI). Обрабатывалась только область лица, фон отбрасывался.
Компрессия геометрии. Использовались дельта-кодирование и предсказание движения вершин между кадрами — аналог современных методов сжатия анимации.
Компрессия текстур. Видеокодеки, адаптированные под UV-пространство лица, с потерями, незаметными на коже.
Потоковая загрузка. В рантайме данные лица подгружались с диска по требованию, аналогично виртуальному текстурированию. Для каждой реплики NPC нужная последовательность кадров загружалась в память, воспроизводилась, затем выгружалась.
Цена вопроса ощущалась сразу: Xbox 360 версия вышла на трёх DVD-дисках, PS3 — на одном Blu-ray, но с заметно ужатым качеством видео. ПК-версия весила около 25 ГБ — для 2011 года это было огромно.
Потоковая загрузка лицевых данных — по сути то же виртуальное текстурирование, но для геометрии и текстур лица. Это был один из самых ранних примеров такого подхода в игровом пайплайне.
Как лицо «приклеивали» к телу
Лицевой захват был полностью отделён от телесного. Тело актёра записывалось традиционным оптическим mocap (вероятно, Vicon) в другой студии, с маркерами на костюме. Голова на теле была либо пустой, либо с простым ригом для ориентации.
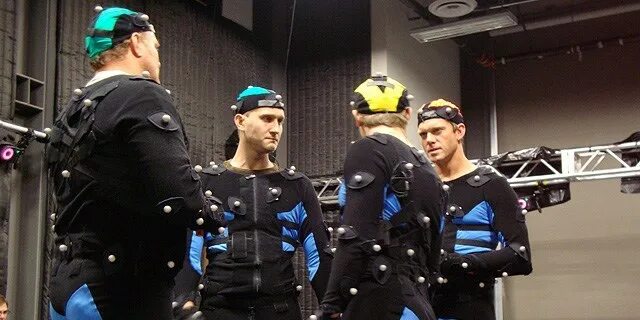
В игровом движке для каждого персонажа воспроизводился скелетный анимационный клип тела, а поверх шеи «прикреплялась» голова с последовательностью MotionScan. Освещение и тени на лице пересчитывались в реальном времени, но исходная текстура содержала запечённое освещение от студийных ламп. Это создавало конфликт: в тёмных сценах лицо могло выглядеть слишком ярким или с неправильными тенями. Для компенсации использовались цветокоррекция и карта нормалей, оценённая из геометрии.
Шея и подбородок часто имели видимый шов — геометрия лица не продолжалась на шею, а текстуры тела были отдельными.
Синхронизация губ с речью была идеальной по определению — актёр произносил реплику прямо во время захвата. Но движения тела и лица записывались в разные моменты, поэтому микрожесты, связанные с позой (например, наклон головы при вопросе), отсутствовали. Актёры сидели неподвижно, глядя в камеру, что иногда давало «отстранённый» взгляд.
Художественная и производственная цена
У MotionScan была не только техническая, но и творческая цена. И она оказалась высокой.
Отсутствие взаимодействия. Актёры записывали реплики по отдельности, часто не видя партнёра. Режиссёр показывал видео или читал текст за второго персонажа. Это напрямую повлияло на естественность диалогов.
Невозможность ретуши. Если актёр моргнул не вовремя или сделал гримасу, приходилось переснимать весь дубль. Пост-обработка геометрии была крайне ограничена — нельзя было поправить блендшейпы, как в классическом пайплайне.
Фиксированная камера. Голова не двигалась, поэтому все повороты головы в игре выполнялись телом или программно, но лицевая анимация оставалась фронтальной. Это заметно в сценах допроса, когда персонаж поворачивает голову — лицо как будто «приклеено».
Единое освещение. Текстура была снята при определённом студийном свете. В игре движок мог менять яркость, но не пересчитывать тени реалистично. Это приводило к эффекту «маски».
Почему MotionScan не стал стандартом
Несмотря на вау-эффект, MotionScan не закрепился в индустрии. Причины лежат на поверхности.
Стоимость и сложность. Риг из 32 камер, мощный вычислительный кластер для обработки, огромные объёмы хранения. Только крупный издатель мог позволить такое.
Несовместимость с традиционным пайплайном. Аниматоры не могли редактировать результат, как обычные кривые или блендшейпы. Любое изменение требовало пересъёмки.
Ограниченная область захвата. Только лицо, без шеи, ушей, волос. Интеграция с телом была болезненной.
Аппаратные требования. Потоковое воспроизведение гигабайтов лицевых данных требовало быстрого диска и памяти. На консолях того времени приходилось идти на компромиссы.
Развитие альтернатив. Вскоре появились маркерные системы с высокой плотностью (DI4D, Captury), а позже — методы на основе машинного обучения (Apple ARKit, Epic MetaHuman Animator), которые дают похожее качество с одной камеры смартфона и при этом редактируются.
После L.A. Noire компания Depth Analysis не выпустила ни одного крупного коммерческого продукта. Технология осталась уникальным экспериментом.
Дискретные точки на лице, ретаргетинг на риг, ручное текстурирование кожи. Редактируется, но даёт «кукольность» и теряет микровыражения.
Лицо целиком как объёмное видео: фотореалистичная текстура, идеальная синхронизация губ, микровыражения «как сняты». Но не редактируется и требует пересъёмки.
Что L.A. Noire оставила индустрии
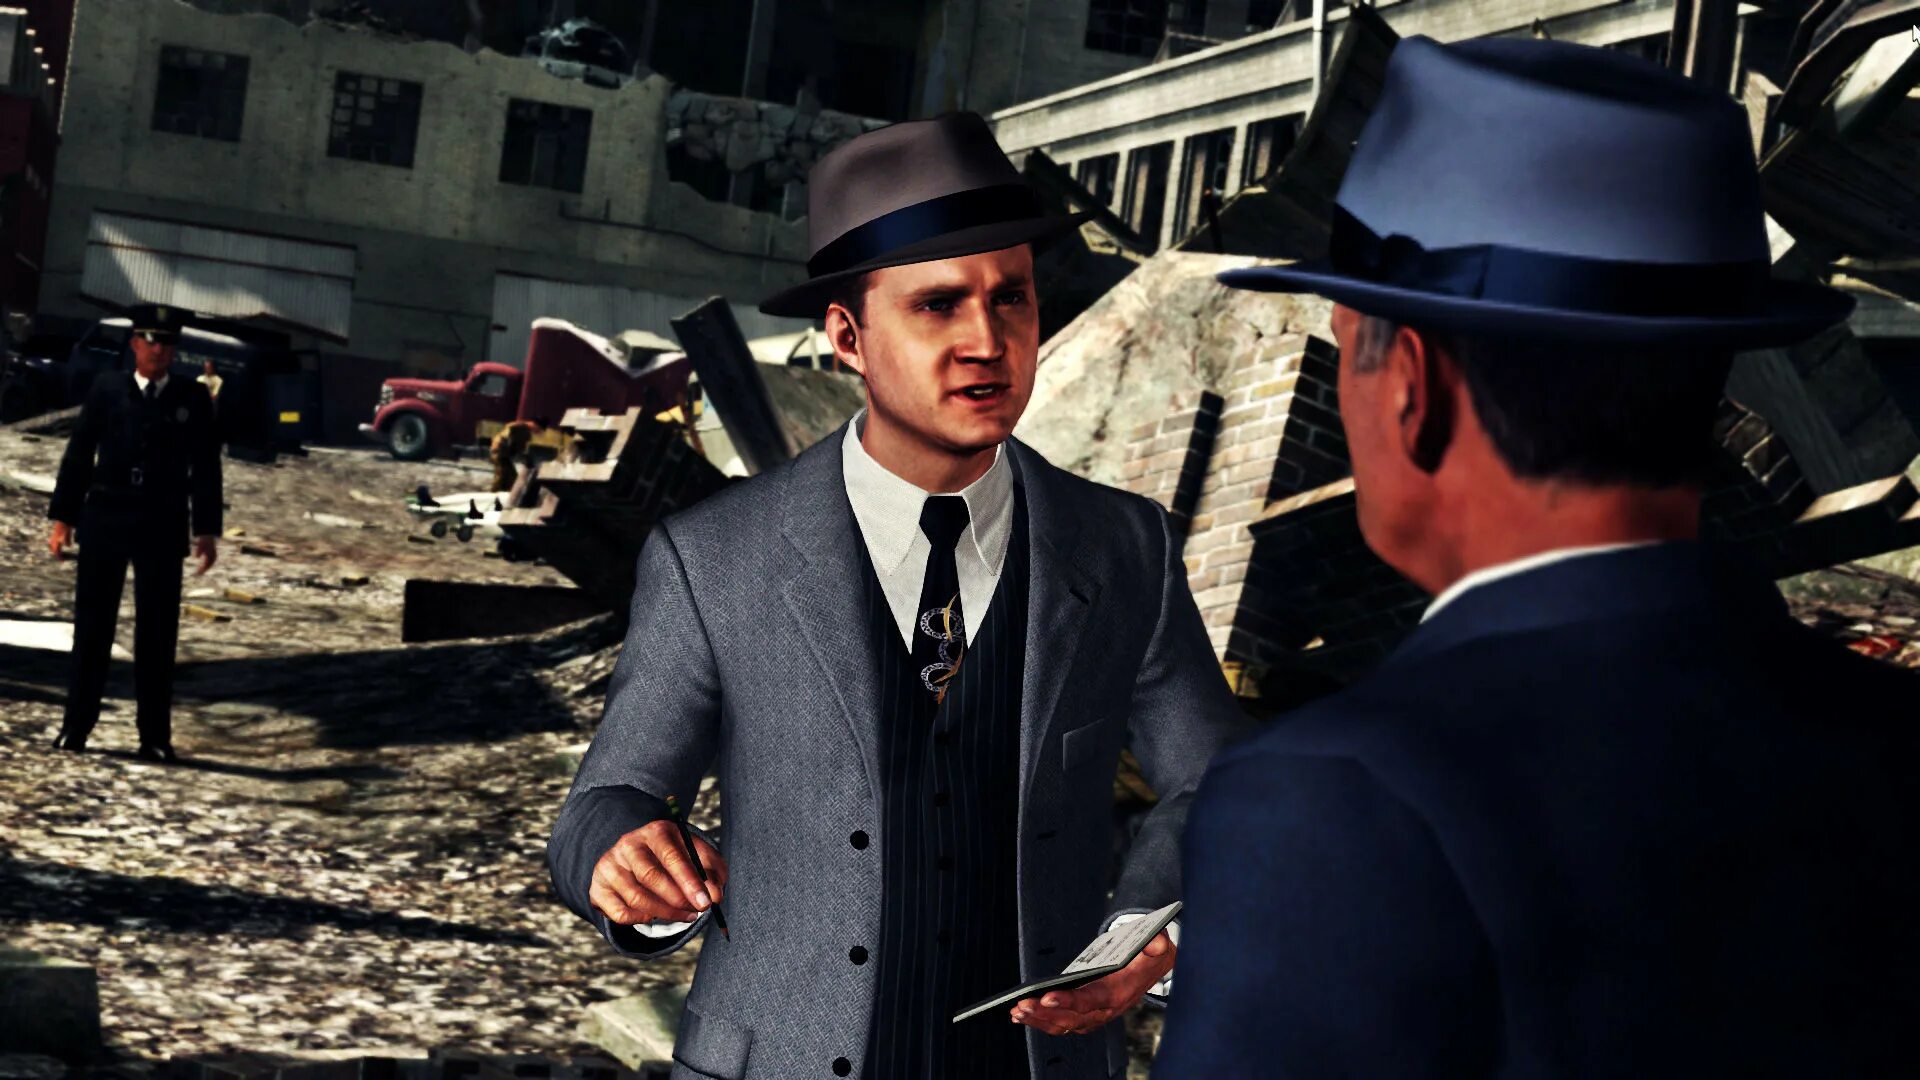
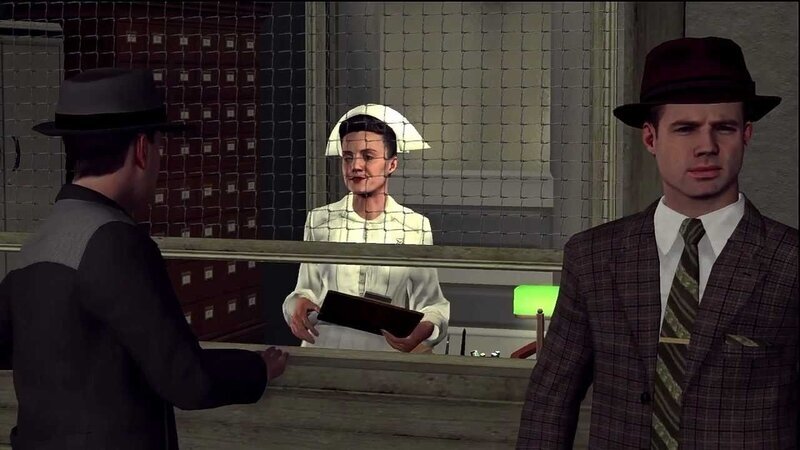
L.A. Noire доказала главное: игроки способны считывать микромимику, и это влияет на геймплей. Система допросов, где нужно распознавать ложь по лицу, работала именно потому, что лица были живыми.
Однако последующие игры Rockstar пошли другим путём. В GTA V и Red Dead Redemption 2 использовались гибридные подходы — маркерный захват лица с последующей ручной анимацией и детальными сканами. Современные системы, такие как MetaHuman Animator (2023), решают ту же задачу — перенос видео лица на 3D-модель в реальном времени с одной камеры, — но дают аниматорам полный контроль над результатом. Того самого контроля, которого не было в MotionScan.
- MotionScan захватывал лицо целиком как объёмное видео: 32 RGB-камеры, multi-view stereo, поток геометрии с видеотекстурой — без маркеров и блендшейпов.
- Классический маркерный захват лица даёт дискретные точки и теряет микровыражения, а MotionScan воспроизводил их «как снято» — ценой гигантских объёмов данных.
- Одна секунда захвата занимала от 100 МБ до нескольких гигабайт; для игры с ~20 часами диалогов это сотни терабайт, что привело к трём DVD на Xbox 360 и 25 ГБ на ПК.
- Главная цена — потеря гибкости: аниматоры не могли редактировать результат, любое изменение требовало пересъёмки, а актёры записывали реплики по отдельности, не видя партнёра.
- Технология не прижилась из-за стоимости, несовместимости с пайплайном и появления редактируемых альтернатив (DI4D, Captury, MetaHuman Animator).
- Наследие L.A. Noire — доказательство, что игроки считывают микромимику, и указание пути: к плотному захвату поверхности, а не дискретных точек.
Для технических специалистов L.A. Noire остаётся примером экстремального инженерного решения: пожертвовать гибкостью ради абсолютной достоверности. Это был тупик — но тупик, который показал, куда движется индустрия. Не к дискретным точкам и ретаргетингу, а к плотному захвату поверхности, который сегодня реализуют MetaHuman Animator и подобные системы. MotionScan просто оказался слишком рано и слишком дорого.