В большинстве игр анимация персонажа — это переключение клипов: игрок нажал кнопку, система выбрала заготовку, состыковала её с предыдущей и надеется, что шов никто не заметит. В The Last of Us Part II швов нет. Движение Элли и Эбби рождается на лету — поиском по библиотеке из тысяч захваченных фрагментов, — а лицо в геймплее работает от базы примерно в 15 000 вручную слепленных поз.
Это не «усовершенствованный» классический пайплайн. Это другая архитектура, и в ней стоит разобраться по слоям: тело, лицо, конвейер захвата.
Стейт-машины против «ведра анимации»
Классическая игровая анимация устроена как конечный автомат. Дискретные состояния — «бег», «поворот налево», «поворот направо» — связаны blend-деревьями, и именно на стыках возникает та механичность, которую игрок считывает бессознательно. Naughty Dog от этого каркаса отказались.
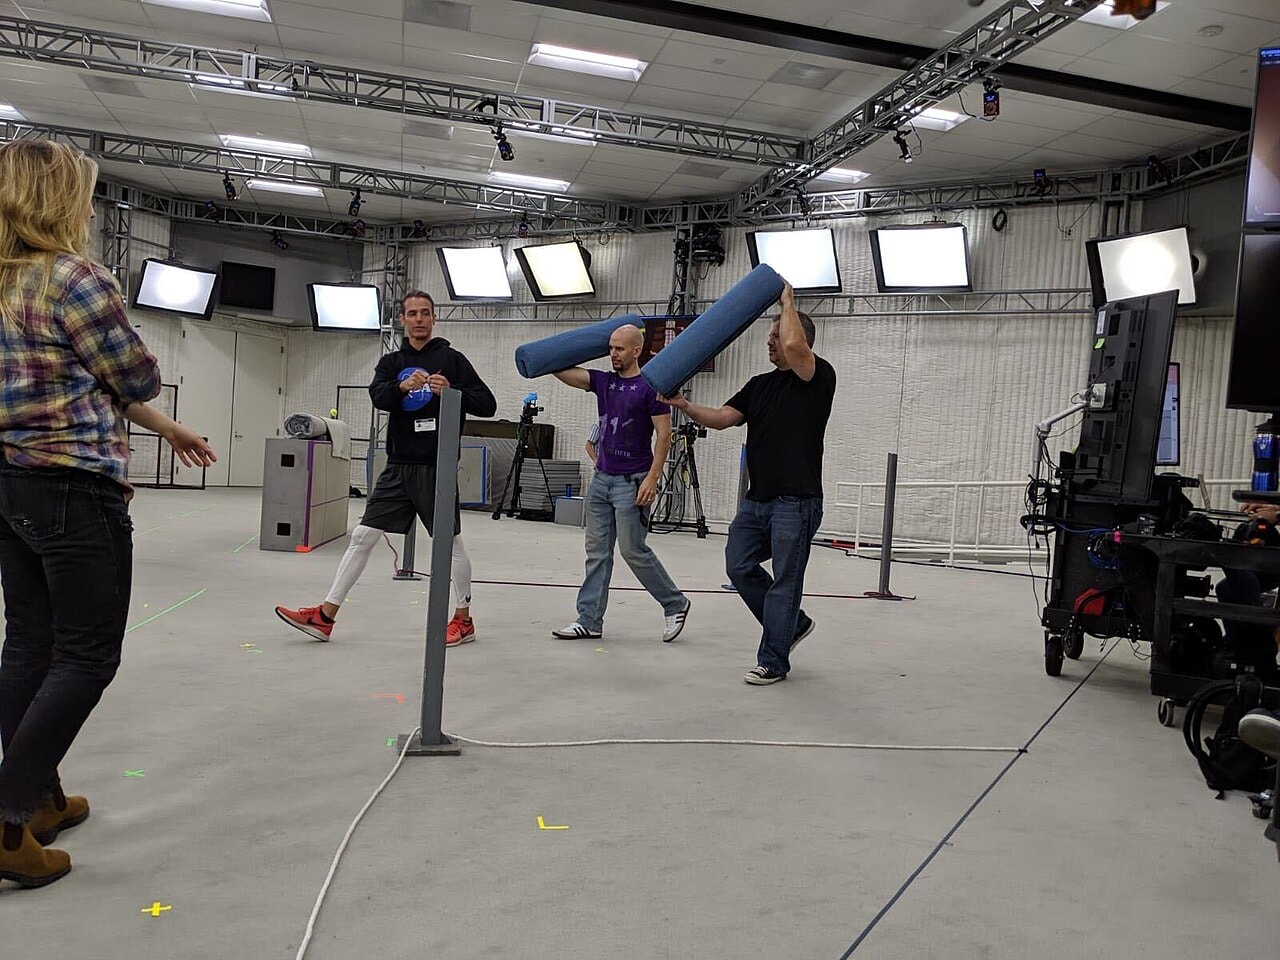
Со-директор игры Энтони Ньюман описывал подход так: система берёт «огромное ведро анимации, сотни и сотни анимаций» и нарезает их на крошечные фрагменты. Дальше в дело вступает Motion Matching — и важно, чего он не делает. Он не выбирает анимацию по команде. Он анализирует текущую траекторию, скорость и ориентацию персонажа, находит в библиотеке фрагменты, которые уже соответствуют этому движению, и покадрово смешивает их.
Дискретные состояния («бег», «поворот») и blend-деревья между ними. Переходы — вручную настроенные стыки; именно на них считывается механичность.
Непрерывный подбор фрагментов под текущую траекторию, скорость и ориентацию. Следующий кадр выбирается автоматически — «заводских» переходов почти нет.
Ключевое слово — непрерывность. Нет момента, когда система «переключается». Каждый следующий кадр — результат оптимизационного поиска по многомерному пространству признаков: позиции стоп, скорости суставов, угловые ускорения. Поэтому каждая остановка и каждый разворот на 180° выглядят так, будто персонаж действительно решил их сделать.
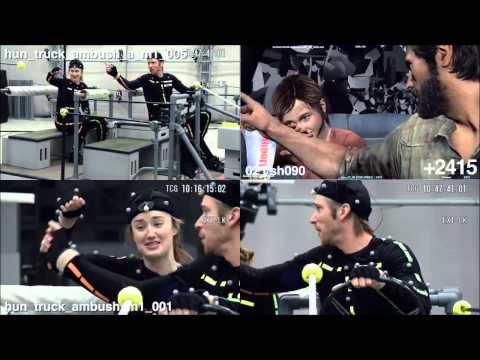
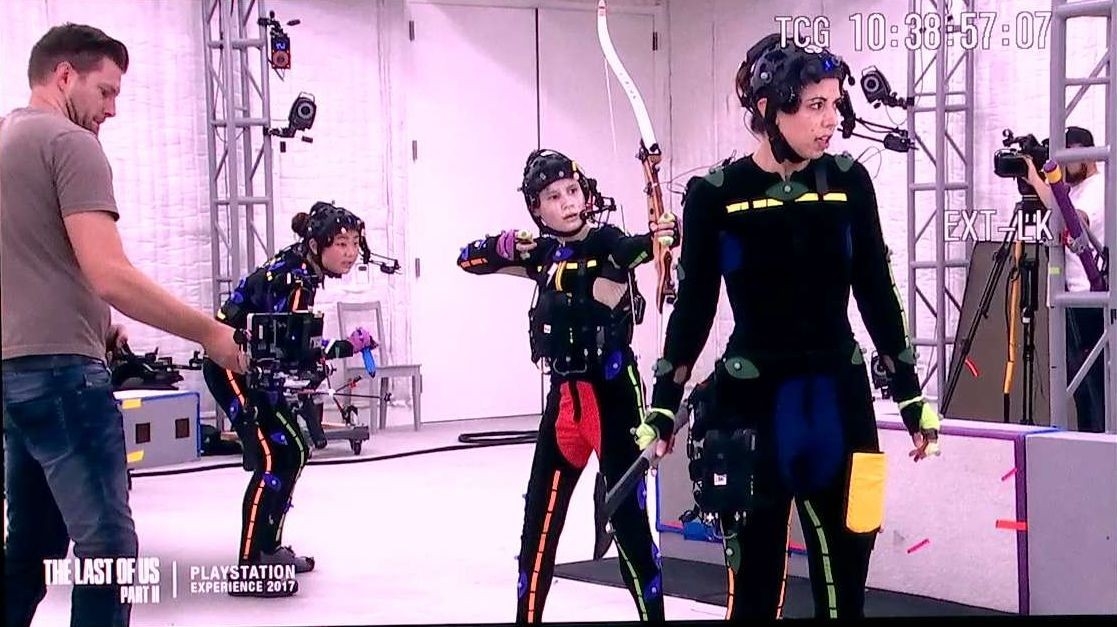
Действовала система на всех: Элли, Эбби, NPC, лошадей и собак. Для животных в студию привозили настоящих лошадей и надевали на них mocap-костюмы — четвероногую базу собирали с той же скрупулёзностью, что и человеческую.
Motion Matching существовал и до TLOU2 — его применяли в For Honor и Rainbow Six: Siege. Разница в масштабе: Naughty Dog построили вокруг технологии весь игровой опыт, а не добавили её отдельным модулем.
15 000 поз: лицо в геймплее
В катсценах всё решает полноценный performance capture: актёры играют сцену целиком, и их мимика переносится на цифровые дубли с идентичной топологией. Вопрос в другом — что происходит, когда катсцена заканчивается и начинается геймплей?
Ответ Naughty Dog — Emotional Systematic Facial Animation, система студийного аниматора Кейта Пачелло. Её архитектура — гибрид ручной художественной работы и рантайм-комбинирования.
Схема такая: у каждого из 25 ключевых персонажей описано примерно 20 эмоциональных состояний, и для каждого набора вручную слеплено порядка 40 поз. На выходе — около 15 000 индивидуальных поз, которые система комбинирует с idle-анимациями прямо в рантайме.
Механику хорошо показывает пример Пачелло из интервью PlayStation Blog. Игрок наводит камеру на картину в синагоге — срабатывает «look at target», размещённый дизайнером. Поверх накладываются саккады: микродвижения глаз, анимированные вручную, которые имитируют бессознательный поиск фокуса. Комбинация eye-aim и саккад и создаёт иллюзию мышления — Элли не просто «смотрит на объект», она его изучает.
Система синхронизирована с диалоговой: триггеры эмоций привязаны к конкретным репликам и битам сценария. И — деталь, выдающая уровень проработки, — эмоциональное состояние переживает границу между катсценой и геймплеем. Если сцена закончилась Элли в слезах, на геймплейной камере её лицо останется заплаканным: текстуры и шейдеры подстраиваются под контекст.
От дубля до цифрового двойника
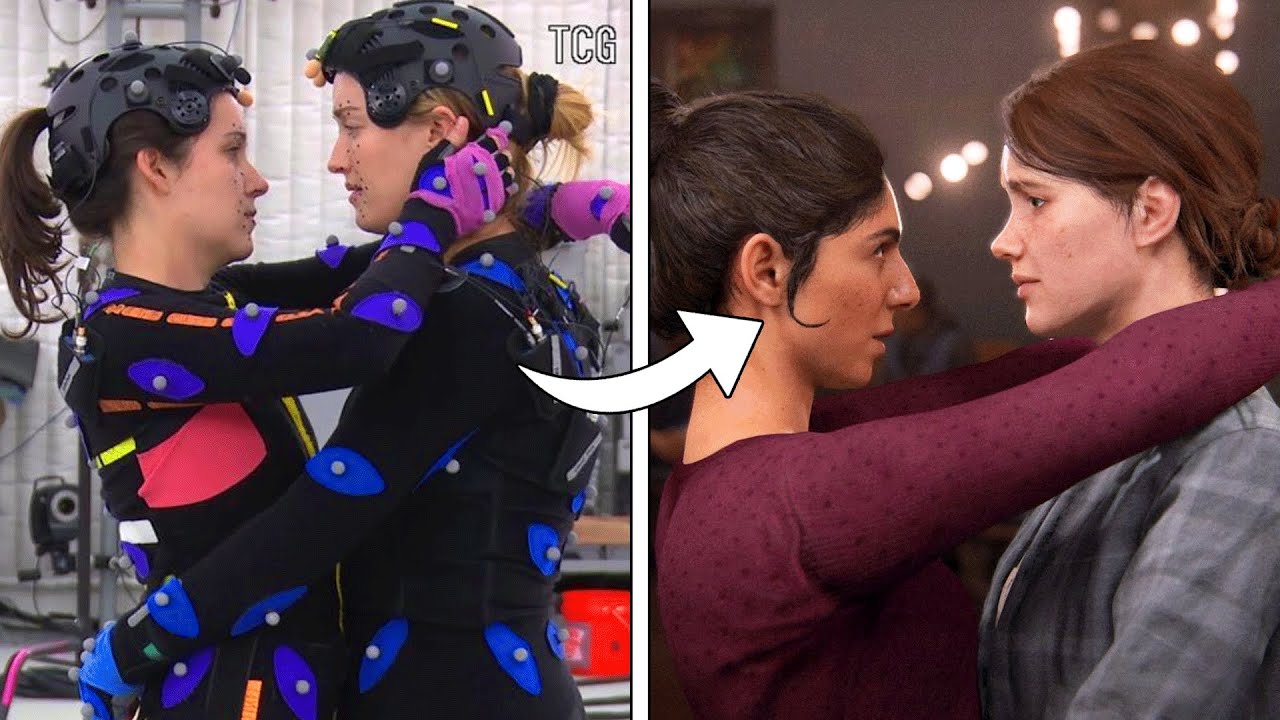
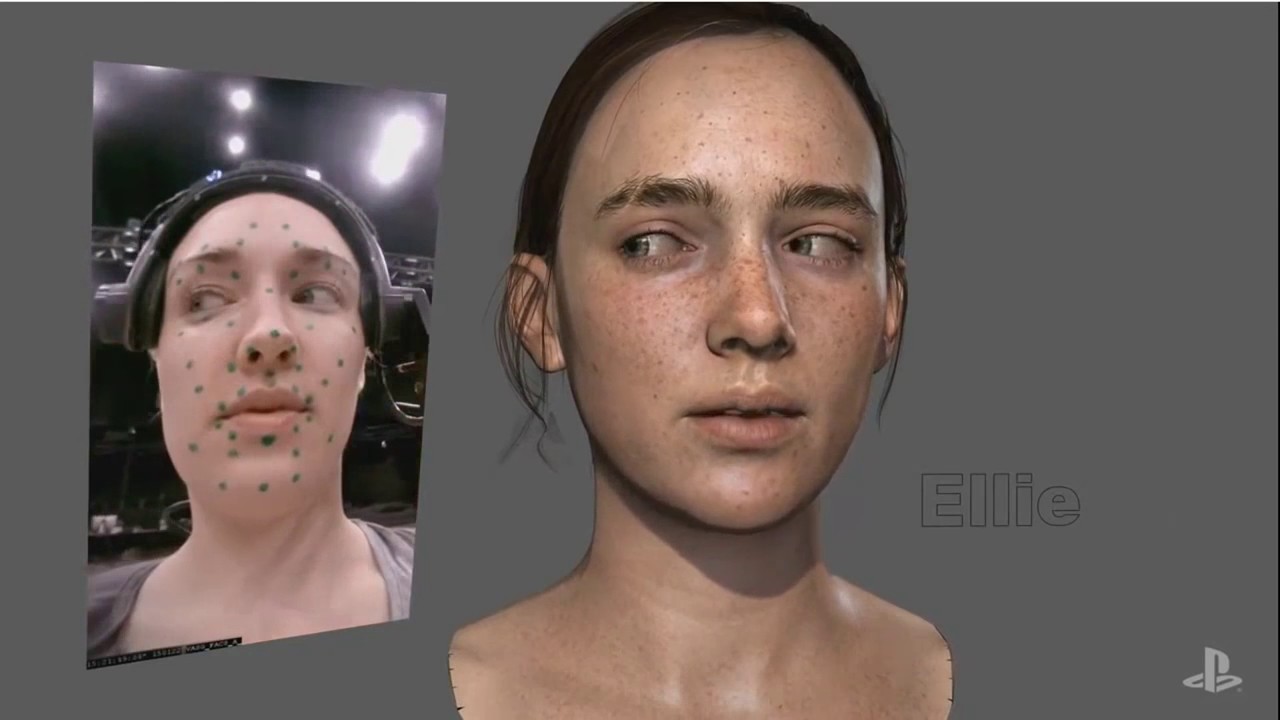
Технологию показали ещё на PlayStation Experience 2016: запись полного диапазона движений лица Эшли Джонсон (Элли) с воспроизведением на её «цифровом двойнике» — модели с идентичной топологией, которую затем транспонировали на раннюю версию лица Элли.
Зачем нужно промежуточное звено? Оно решает фундаментальную проблему: аниматоры получают чистый, семантически осмысленный сигнал performance capture, не искажённый разницей топологии между актёром и персонажем. Двойник хранит мимику в «сыром» виде, а перенос на финальную модель учитывает артикуляционные ограничения персонажа.
Каскадёры вместо аниматоров
Физическую пластику персонажей ставил не аниматор с keyframe-кривыми, а человек с реальным двигательным опытом. Большую часть mocap-работы для Эбби выполнила каскадёр Эми Джонстон — плюс движения для Элли, Дины, Яры и Лева. Походка, боевые стойки, язык тела персонажей наследуют её двигательному опыту, а не фантазии аниматора.
«Отсутствие анимации» как высшая похвала
Синтез Motion Matching и Emotional Systematic Facial Animation создаёт то, что критики и игроки описывают как «отсутствие анимации». Нет кадра, о котором можно сказать: «вот здесь система переключилась». Переход между бегом и ходьбой, нейтральным лицом и гримасой боли, катсценой и геймплеем живёт в едином непрерывном пространстве состояний.
Разница между «использовать Motion Matching» и «построить игру вокруг Motion Matching» — это разница между технологией и ремеслом. Именно поэтому анимация TLOU2 ощущается не как результат работы аниматоров, а как поведение: живое, непредсказуемое, человеческое.
- Motion Matching заменяет стейт-машины: каждый кадр — результат поиска по многотысячной базе захваченных фрагментов, а не выбор заранее заготовленного клипа.
- Система покрывала всех — Элли, Эбби, NPC, лошадей и собак; для животных делали настоящий mocap в костюмах.
- Лицо в геймплее работает на ~15 000 скульпт-поз: ~40 вручную слепленных поз на каждое из ~20 эмоциональных состояний 25 ключевых персонажей.
- Эмоция переживает границу катсцены и геймплея: состояние лица сохраняется, текстуры и шейдеры подстраиваются под контекст.
- Мимика Эшли Джонсон переносилась через цифровой двойник с идентичной топологией, а пластику Эбби ставила каскадёр Эми Джонстон.