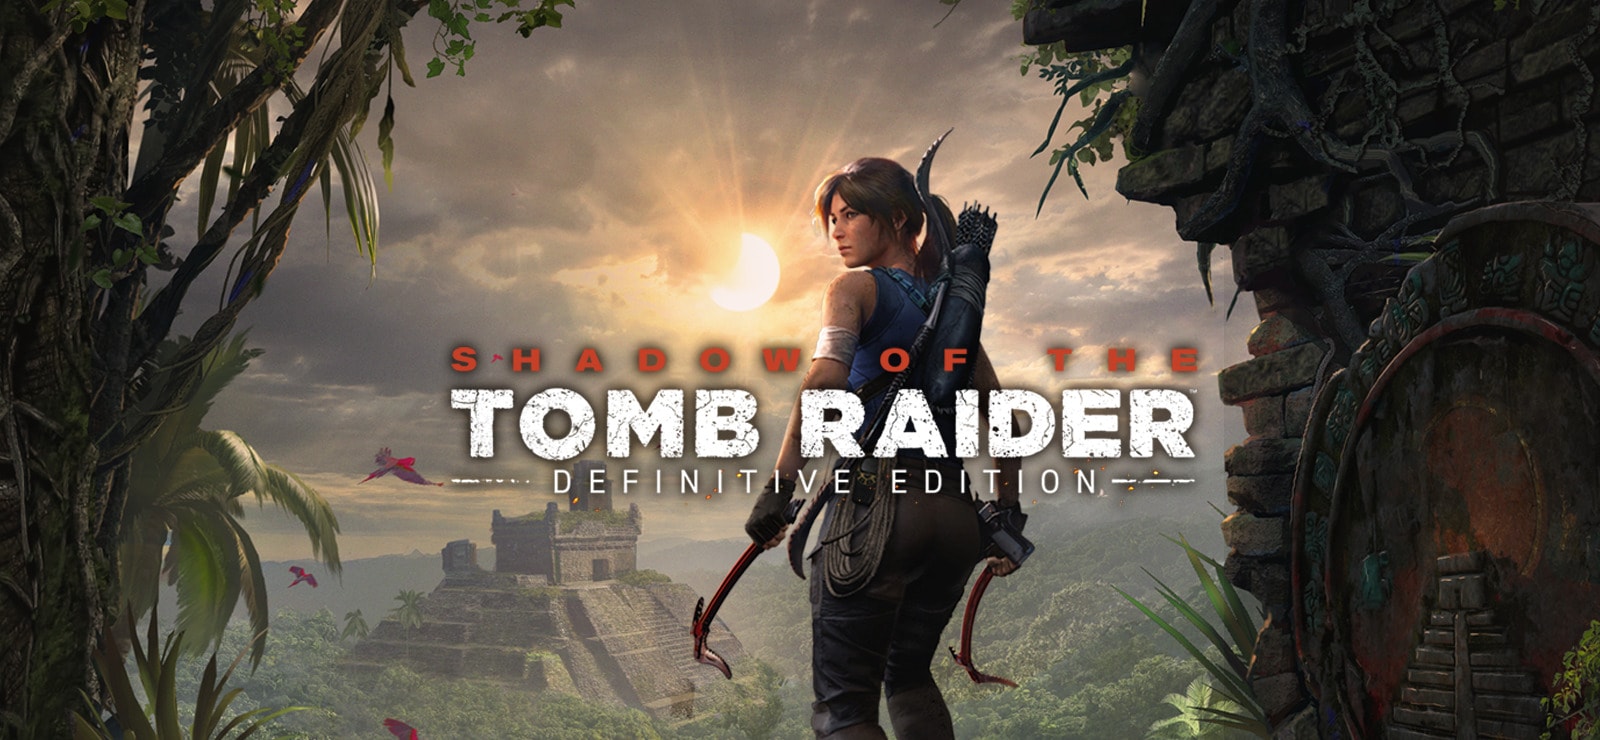
Сцена, знакомая каждому mocap-артисту: актриса в костюме с серыми маркерами, шлем с камерами, а вместо джунглей Перу — ровный серый пол студии. Shadow of the Tomb Raider (2018) закрыла перезапускную трилогию о Ларе Крофт и стала её самой тёмной частью — а значит, самой требовательной к performance capture: фальшь в мимике на таком материале видна сразу.
Ведущим разработчиком выступала Eidos-Montréal, и команда анимации ставила цель сделать персонажей настолько живыми, чтобы игрок забыл о полигонах. Разбираем, что для этого понадобилось: репетиции, флуоресцентная краска MOVA, съёмочный день изнутри и ручная полировка тысяч точек данных.
Сначала репетиции, потом маркеры
Процесс начинался задолго до съёмок. Камилла Ладдингтон, исполнительница роли Лары во всей трилогии, рассказывала, что сценарий перед съёмками «доводился до ума»: сцены прорабатывались так, чтобы актёрам было понятно не только что говорить, но и как двигаться. Для третьей части это было принципиально — тон игры заметно потемнел, и эмоциональная нагрузка на персонажей выросла.
Режиссёр перформанса Дэррил Пёрди и ведущий сценарист Джилл Мюррей работали в связке с актёрами: объясняли контекст каждой сцены и добивались согласованности голоса, мимики и жеста ещё на площадке. Актёры не начитывали реплики в микрофон — они физически отыгрывали сцены, как в кино.
MOVA: флуоресцентная краска вместо маркеров
Классический facial capture — это «стразы»: несколько десятков маркеров на лице. В Tomb Raider пошли другим путём — использовали систему MOVA Contour Reality Capture: лицо актёра покрывается флуоресцентной краской, а камеры по периметру считывают её рисунок.
Рост с девяноста маркеров до тысяч точек — это не про «более красивую картинку», а про другой уровень деталей: движение глаз, напряжение мышц, то, как губы обрисовывают зубы в эмоциональной сцене. Именно микромимика решала, поверит ли игрок в героиню, которая в этой части больше плачет и сомневается, чем скачет по лианам.
У MOVA были и юридические сложности: использование системы стало предметом спора ещё на Rise of the Tomb Raider. Для третьей части разработчики подтверждали, что facial capture улучшили — особенно в передаче деталей глаз, — однако точная конфигурация системы официально не раскрывалась.
Захват тела остался классическим: костюм с маркерами и камеры по всему объёму студии. Ладдингтон описывала свой съёмочный образ так: костюм с серыми точками для отслеживания жестов плюс шлем с камерами для лицевого захвата.
Одна Лара на всё
Ладдингтон — редкий для индустрии случай полного performance capture: она обеспечивала и голос, и движения, и мимику Лары на протяжении всей трилогии. К третьей части нагрузка выросла: по её словам, игра «давила эмоционально и физически сильнее» двух предыдущих. Сцены смерти, падений и срывов она отыгрывала буквально — с криками и полным погружением в образ.
Часть сцен захвата движения Лары исполнила Стефани Паниселло, указанная в титрах как motion capture actor for Lara Croft. Для сложных акробатических и боевых сцен так приглашают профильных исполнителей — как каскадёров в кино.
Джону Майави озвучил и отыграл Эрл Бэйлон — вместе с Ладдингтон они снимали совместные сцены на одной площадке, поэтому взаимодействие персонажей сохранило естественность: паузы, взгляды, физические реакции.
Серая комната вместо джунглей
Съёмочный день в mocap-студии выглядит одинаково буднично. Актёры приходят на площадку, надевают костюмы с маркерами и шлемы, режиссёр объясняет сцену — и она отыгрывается в реальном времени. Камеры фиксируют движения, а софт сразу собирает черновую анимацию, которую можно посмотреть на экране прямо после дубля.
Главное испытание здесь не физика, а воображение. Актёры не видят ни финальных моделей персонажей, ни окружения: они работают в «серой» среде и верят в обстоятельства, которых физически не существует. Ладдингтон сравнивала процесс с театром — и это точнее любых технических описаний: сначала вера, потом техника.
Для трюков — прыжков, падений, драк — на площадке лежали маты и стояла страховка. Но отыгрывать всё равно требовалось всерьёз: правдивый перформанс аниматорам чистить проще, чем героический, но деревянный.
Сырой захват против финального кадра
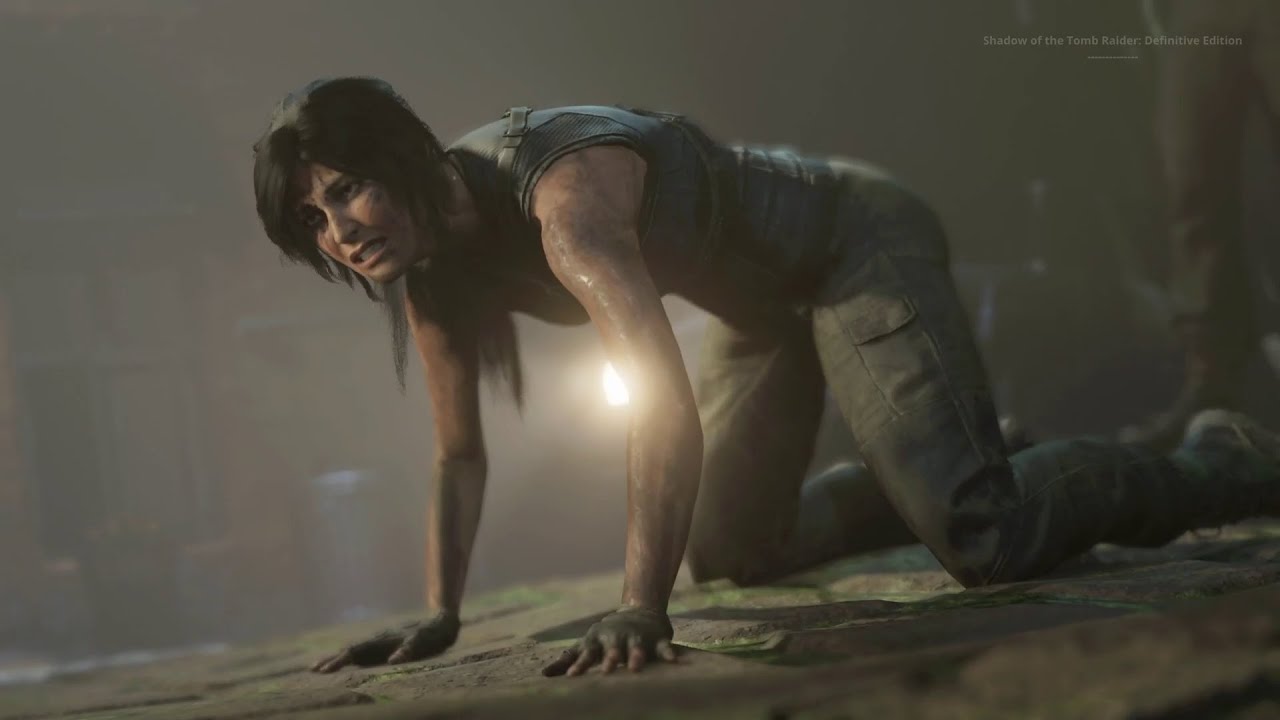
Тот самый разрыв, о котором обычно умалчивают трейлеры, — как выглядит съёмка и что получает игрок.
Актёр в костюме с маркерами на серой площадке. Сырые данные: силуэт, динамика, игра голоса. Шлем с камерами пишет лицо, но рендера нет — только точки, из которых аниматорам ещё предстоит собрать персонажа.
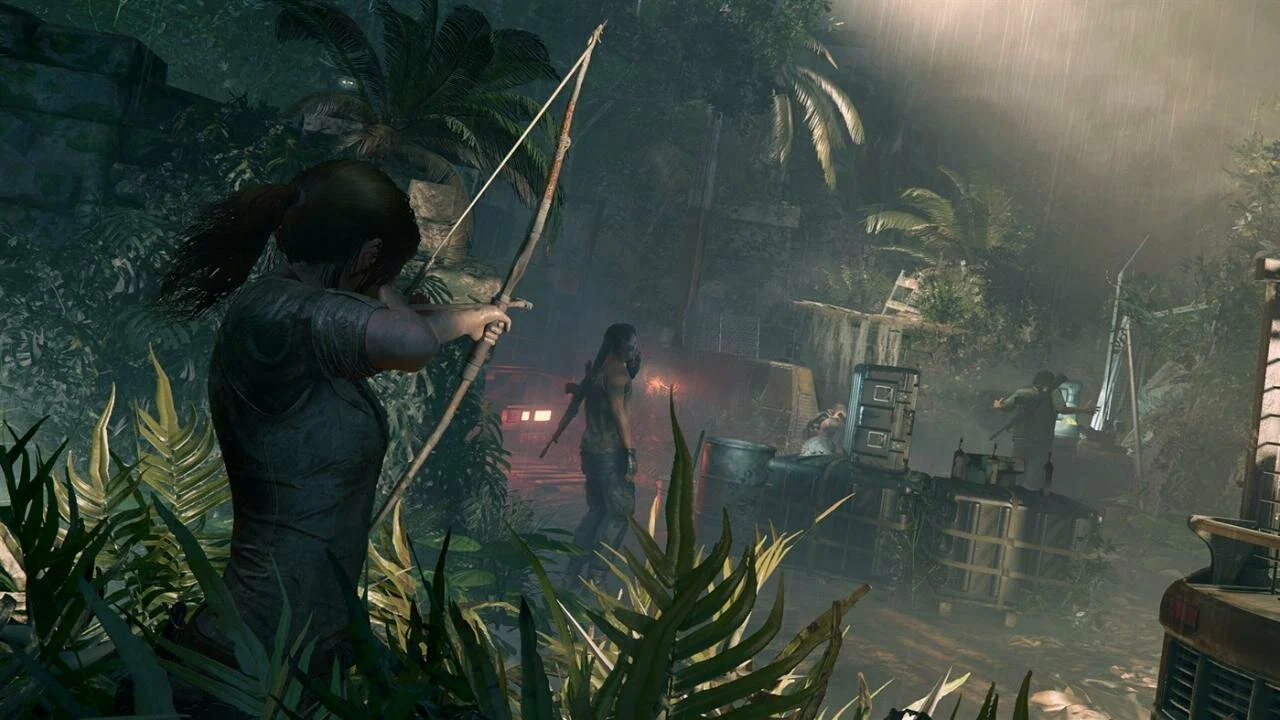
Тот же перформанс после ретаргета на модель Лары, cleanup'а данных и ручной полировки: мышцы, глаза, дыхание. Всё, что сыграл актёр, сохранено — поверх добавлена только графика.
Что было самым сложным
Режиссёр анимации Дэвид Юбер описывал игру как «гораздо более тёмную» по тону, а многие сцены — как требующие «довольно высокой интенсивности» перформанса. На практике это означало: Ладдингтон приходилось кричать, плакать и задыхаться в костюме с маркерами под прицелом десятков камер — и делать это убедительно дубль за дублем.
Второй вызов — синхронизация. Лицо и тело захватывались разными системами и обрабатывались раздельно: чтобы жест и мимика совпали в одном кадре, аниматоры сводили их вручную. У дополнительных персонажей качество facial capture было ниже, чем у Лары, — и это заметно даже неподготовленному глазу.
Третий — объём данных. Тысячи точек MOVA на каждый кадр требуют серьёзных вычислительных ресурсов и времени на постобработку: данные вручную очищают от артефактов и сглаживают переходы. Детализация всегда стоит человеко-часов.
Лара, в которую веришь
Итог — самый детализированный performance capture в трилогии. Лара в Shadow of the Tomb Raider ведёт себя как живой человек: микродвижения глаз, напряжение мышц в динамичных сценах, дыхание после подъёма. Значительная часть эмоций передаётся без единого слова — взглядом, позой, паузой.
- Полный performance capture одной актрисой: голос, тело и мимика Лары в одном исполнении, с дублёршей для трюковых сцен.
- MOVA Contour с флуоресцентной краской дала тысячи точек на лице против ~90 маркеров классического подхода — и вместе с ними микромимику.
- Лицо и тело захватывались раздельно: согласованность картинки — ручная работа аниматоров на постобработке.
- Технология решает половину задачи; вторая половина — актёрская игра в серой комнате и часы cleanup'а.
Хорошая технология не отменяет плохого перформанса — она только честнее его показывает. Именно поэтому мы в MocapTric смотрим на production capture как на съёмочный процесс в целом: от репетиций и постановки сцены до чистки данных. Если планируете съёмки и хотите обсудить пайплайн — расскажите о задаче, разберём её вместе.