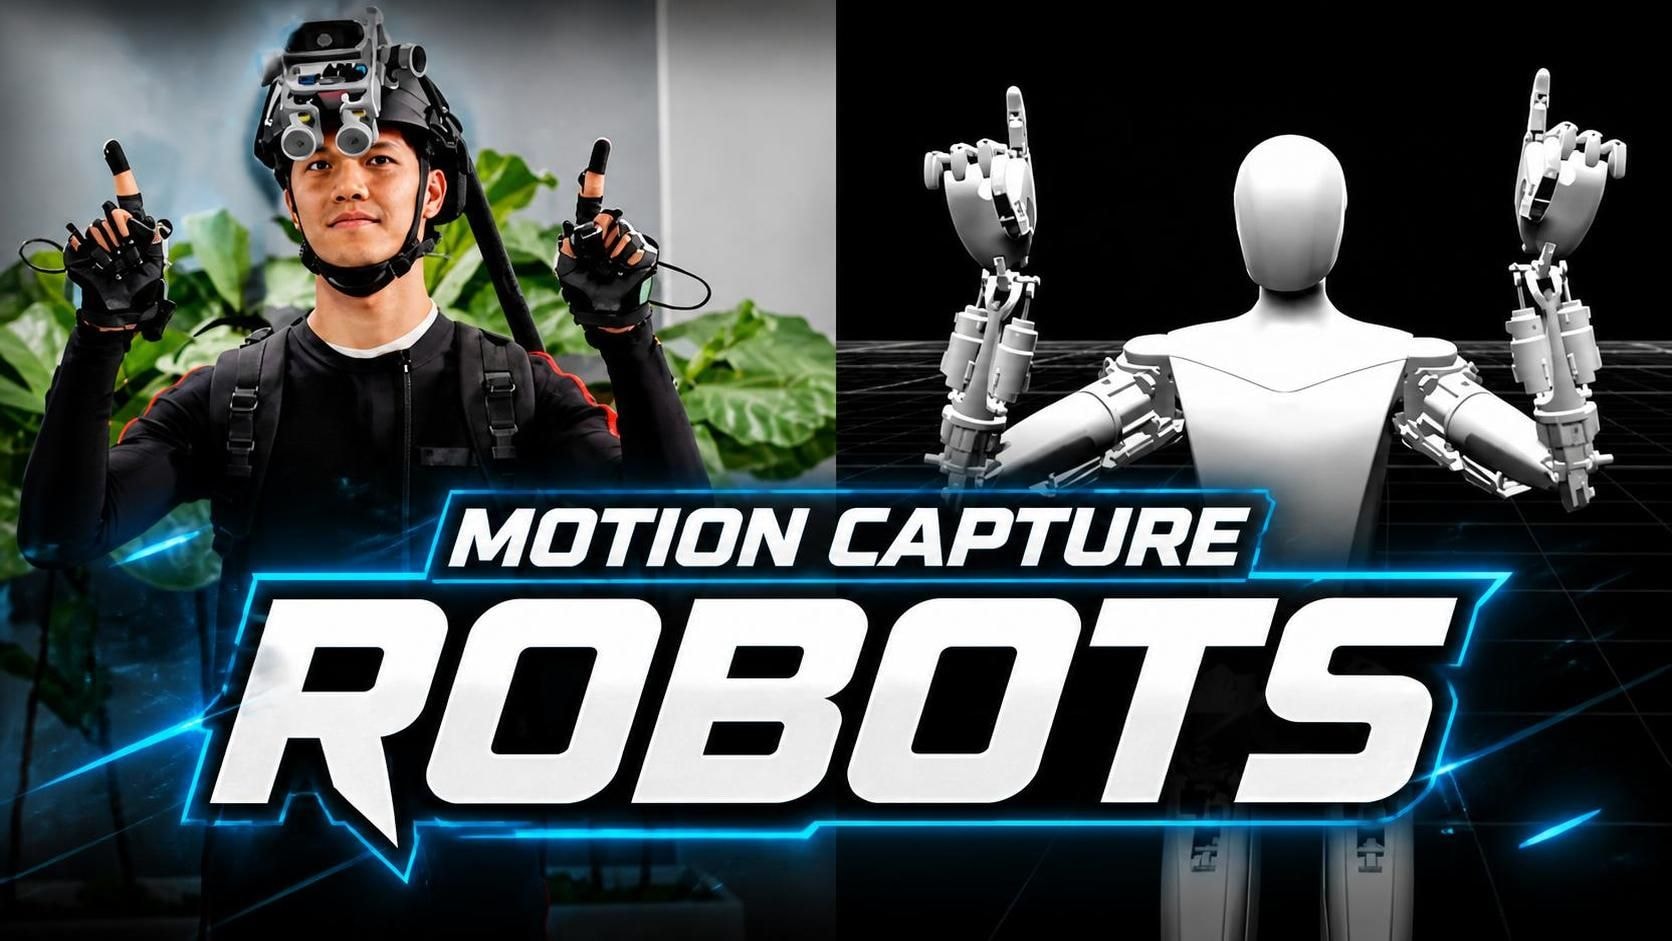
Гуманоид Atlas уходит в армейский ползок, а затем выбирается в брейк-данс — движения, которые никто не писал построчно. Их показал человек, алгоритмы подсмотрели запись и превратили её в навык. Тот же путь прошли танцы и кунг-фу у роботов Unitree G1.
За этими демо стоит производственный конвейер, оформившийся в отраслевой стандарт: захват движения → ретаргетинг на робота → масштабное обучение в симуляции → развёртывание на железе. Разбираем каждое звено — и то, где оно до сих пор ломается.
Зачем роботу человеческий учитель
Собирать демонстрации напрямую на роботе — через телеуправление или ручное программирование — дорого, медленно и изнашивает аппаратуру. Каждый час телеоператорской сессии оплачивается вместе с амортизацией железа, а скорость сбора данных упирается в количество самих роботов.
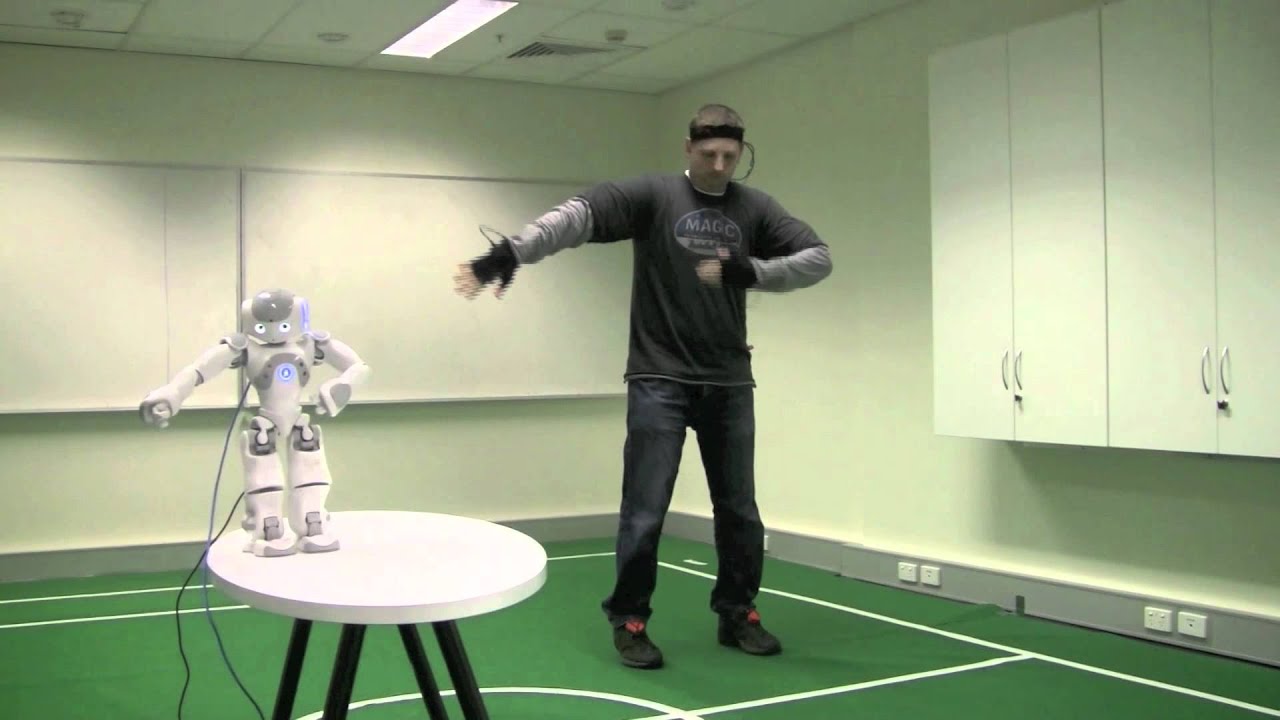
Человеческие демонстрации шире: записать их можно через системы захвата движения, обычное видео и анимацию. Если удаётся надёжно перевести эти движения в траектории, исполнимые роботом, объём обучающих данных растёт на порядок — а гуманоид получает навыки, которые человек оттачивал годами.
Конвейер: от костюма до политики управления
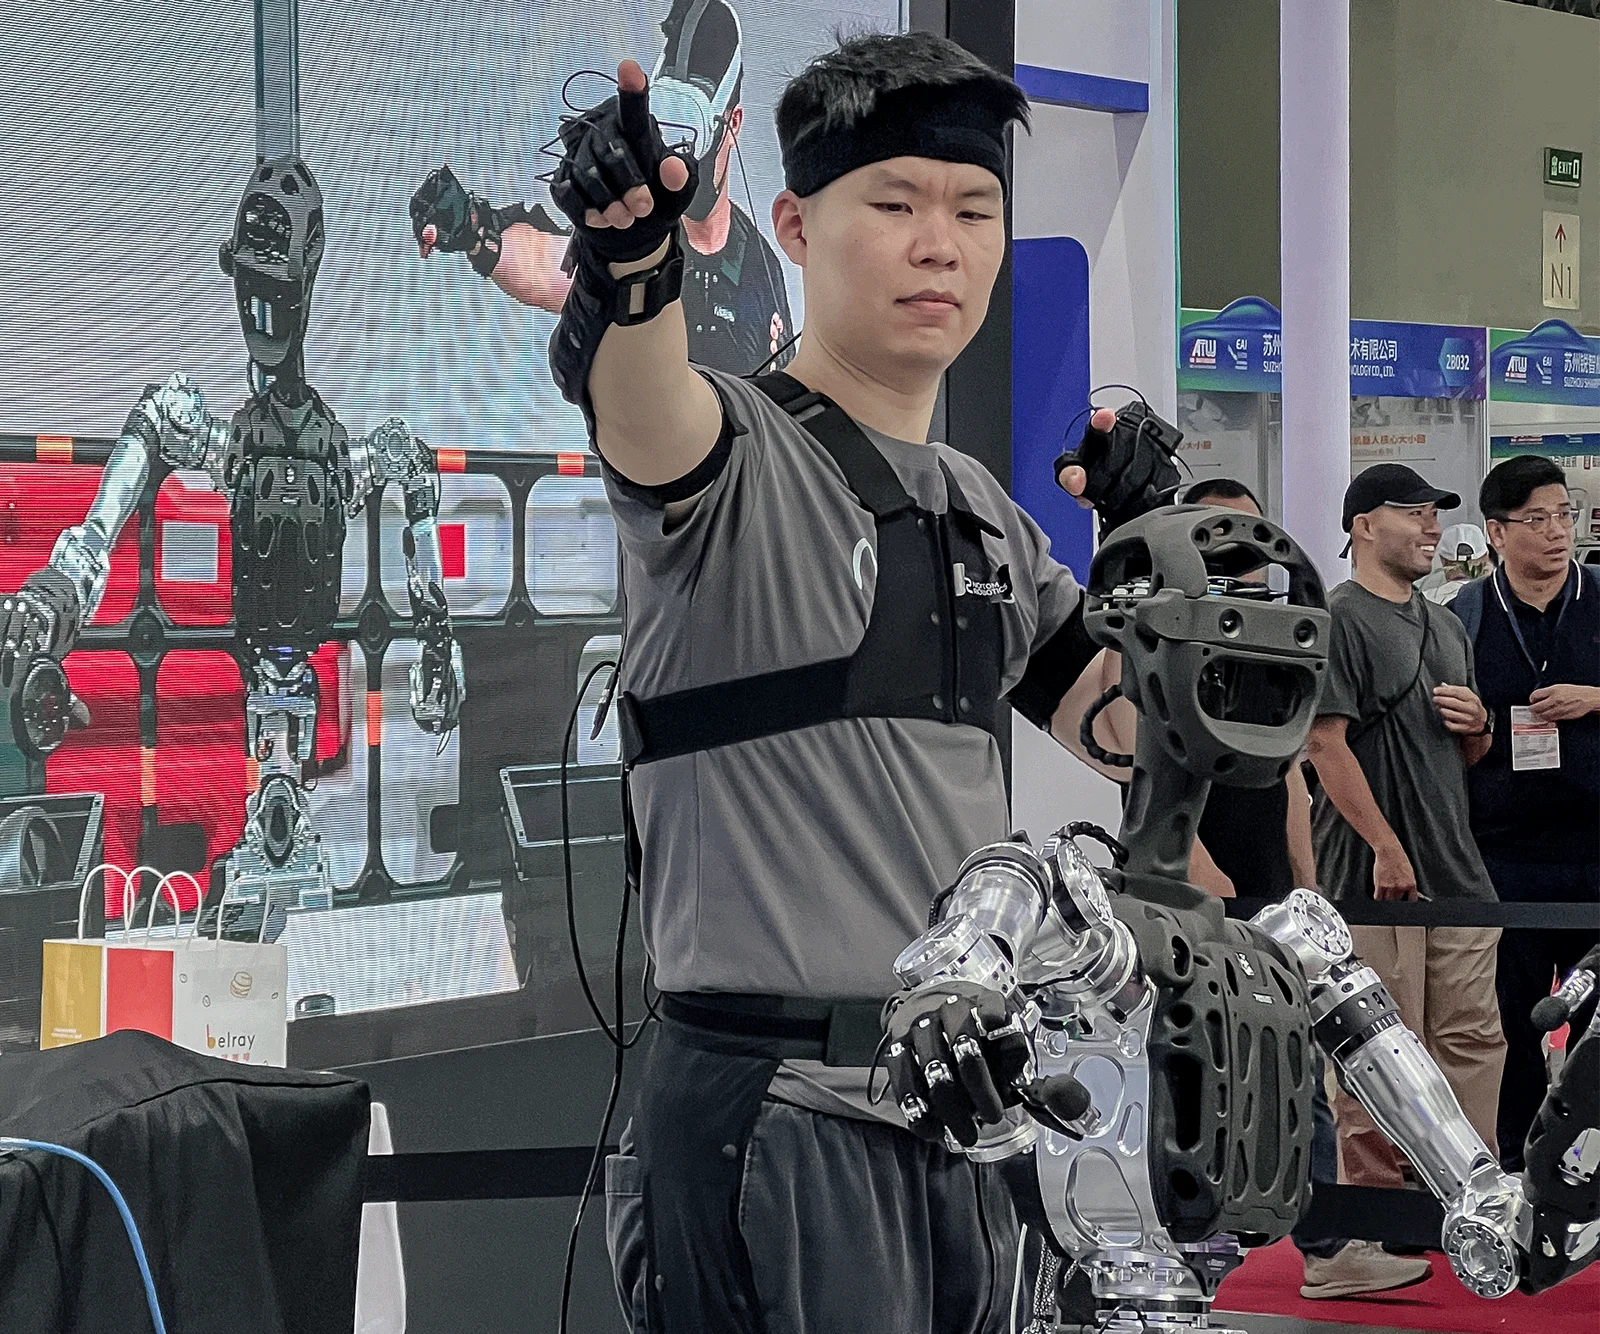
Современные команды, включая Boston Dynamics, сходятся к единому циклу: захват человеческого движения → ретаргетинг на робота → масштабное обучение в симуляции → развёртывание на железе → итерация. Пройдём по цепочке шаг за шагом.
Захват: движение становится данными
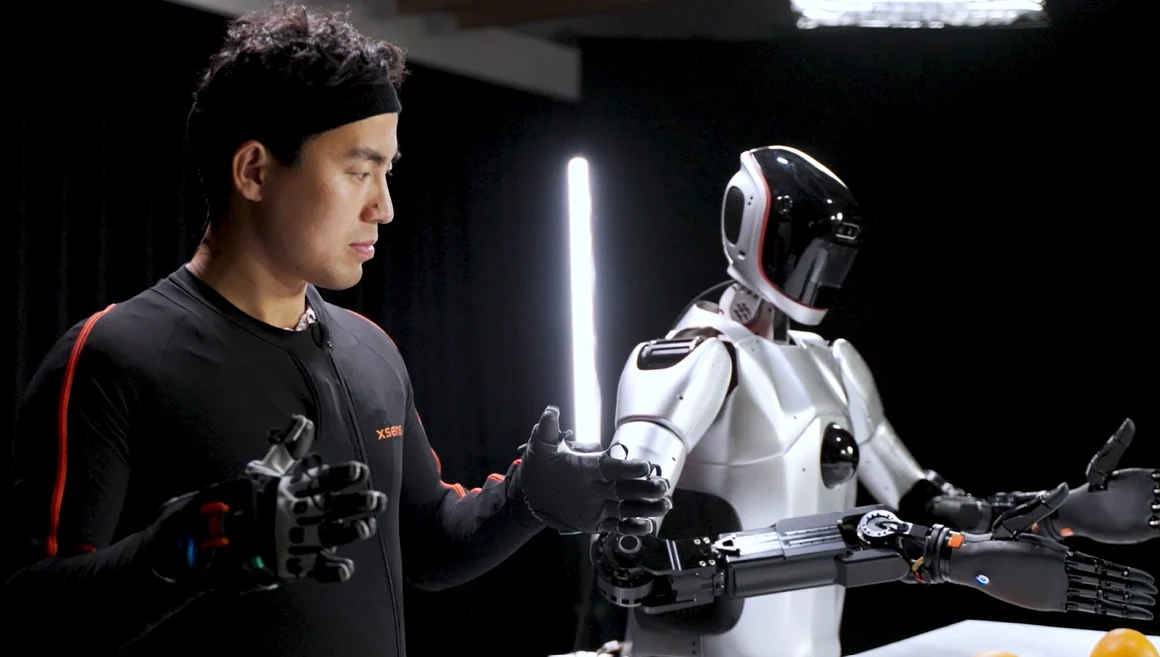
Всё начинается с костюма. Системы вроде Xsens записывают углы суставов, тайминг и координацию — на выходе получается эталонное поведение, которое можно воспроизводить, итерировать и расширять. Есть и специализированные носимые решения: например, экзоскелетная система HumanoidExo, разработанная для обучения роботов, показала 80% успеха на сложных задачах захвата и размещения объектов.
Точность критична. Для обучения гуманоида нужны данные кинематики всего тела и точное отслеживание пальцев — права на «примерно» кисть с её степенями свободы не оставляет.
Ретаргетинг: мост между двумя телами
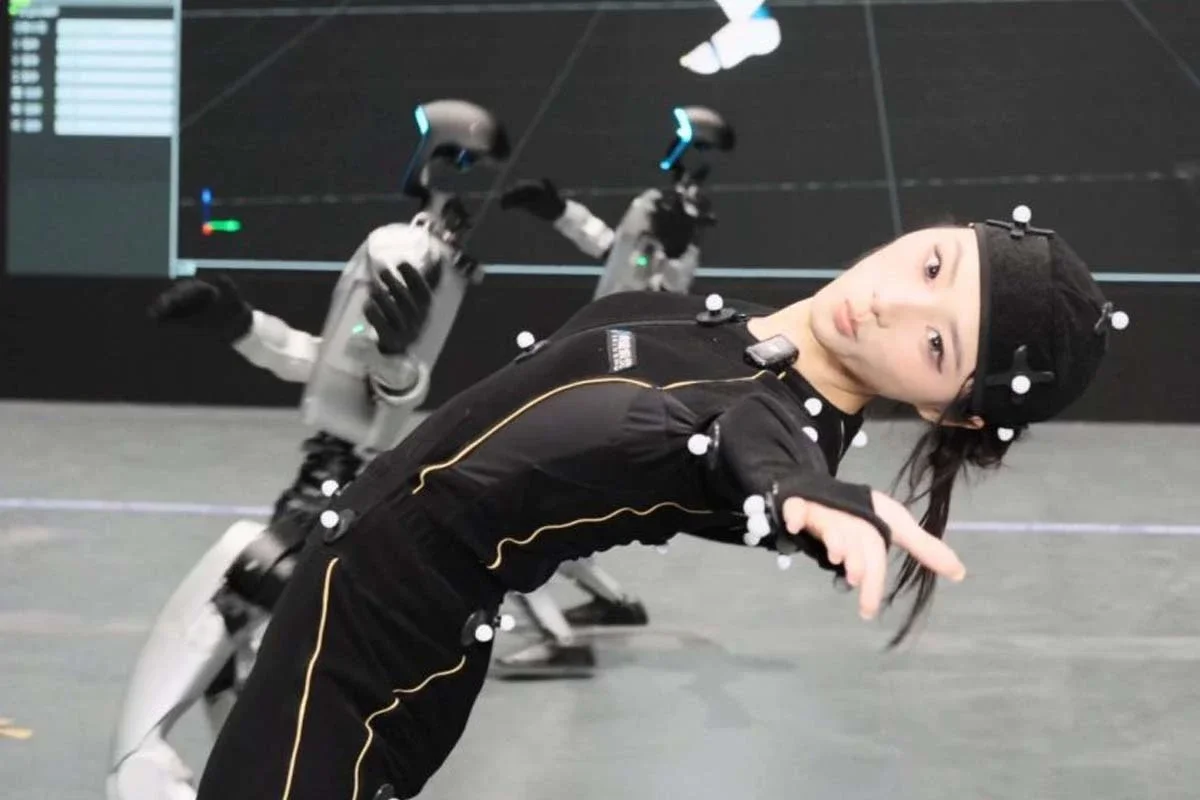
Скопировать человеческое движение на робота «в лоб» нельзя. У Atlas, как и у любого гуманоида, другие пропорции конечностей, другие ограничения суставов и другие приводы. Задача ретаргетинга — перевести движение из одного тела в другое, но подходы к переводу различаются.
Классический метод сопоставления ключевых точек пытается совместить глобальные позиции тела человека и робота. Проблема видна на конкретном примере: робот Unitree G1 ростом около 1,3 метра имитирует человека ростом 1,8 метра. Простое масштабирование даёт физически неправдоподобные результаты — руки робота оказываются внутри коробки, а не на её поверхности. Хуже того, такие методы часто игнорируют взаимодействие с объектами и средой, хотя при переносе коробки или подъёме на платформу сохранение контактов и есть задача.
Проект OmniRetarget, получивший двойную награду на ICRA 2026, предлагает принципиально иной подход: сохранять не точную позу человека, а важные отношения между телом, объектами и окружающим рельефом. Система DynaRetarget идёт дальше — уточняет несовершенные кинематические траектории через оптимизацию на основе сэмплирования, доводя их до динамически исполнимых.
Совмещение глобальных позиций ключевых точек. При разнице роста простое масштабирование ломает контакты: руки робота проваливаются сквозь коробку, взаимодействие со средой теряется.
Сохранение отношений «тело — объекты — рельеф» вместо точной позы. Двойная награда ICRA 2026; в связке с DynaRetarget траектории доводятся до физически исполнимых.
Качество ретаргетинга напрямую влияет на обучаемость политики управления. Скольжение стоп, самопересечения и физически невыполнимые движения, оставленные в эталонных траекториях, заметно снижают робастность обученной политики — особенно на динамичных и длинных последовательностях.
Обучение: имитация и подкрепление
После ретаргетинга начинается обучение. Здесь работают два базовых подхода.
| Имитационное обучение | Обучение с подкреплением | |
|---|---|---|
| Идея | Политика учится воспроизводить эталонные траектории | Политика учится адаптировать движение под ограничения робота |
| Сильная сторона | Точное следование за человеческой записью | Робастность и генерализация |
| Характерные примеры | Гибридный loco-manipulation, DIH2H | ZEST, SoftMimic |
В имитационном обучении политика напрямую воспроизводит эталонные траектории. Гибридный подход для задачи loco-manipulation совмещает отслеживание верхней части тела и корня из MoCap-данных с дополнительным контролем от предобученного эксперта по ходьбе — движения ног соблюдают динамические и кинематические ограничения робота. Фреймворк DIH2H разделяет работу: нижняя часть тела учится через имитацию, верхняя — через имитацию плюс curriculum learning. Результат — 10-процентный рост точности имитации и 25-процентная экономия данных.
Обучение с подкреплением позволяет не копировать, а приспосабливать. ZEST (Zero-shot Embodied Skill Transfer) обучает политики через RL из разнородных источников — высокоточного захвата движения, шумного монокулярного видео и анимации без физических ограничений — и разворачивает их на железе без дообучения. На роботе Atlas система освоила армейский ползок и брейк-данс из MoCap, а выразительный танец и подъём на коробку — непосредственно из видео.
Фреймворк SoftMimic решает проблему жёсткости управления: вместо агрессивной коррекции отклонений от эталона он вознаграждает податливые реакции. Робот поглощает возмущения и безопасно взаимодействует с окружением вместо того, чтобы судорожно возвращаться к идеальной позе.
Симуляция: 4000 Атласов параллельно
Обучение полностью в симуляции — стандарт для современных систем. Boston Dynamics обучает более 4000 цифровых двойников Atlas параллельно в течение шести часов, добавляя вариативность: скользкие полы, уклоны, жёсткие суставы. Так система учится быстрее реального времени и безопасно исследует граничные случаи — падение в симуляции не стоит ничего.
Перенос в реальный мир остаётся сложной задачей из-за sim-to-real gap — несоответствия между упрощёнными моделями симулятора и реальной динамикой приводов. Фреймворк визуального sim-to-real VIRAL решает проблему комбинацией масштабной доменной рандомизации (освещение, материалы, параметры камер) с реально-симуляционным выравниванием кисти и камер. Результат: RGB-политика, развёрнутая на Unitree G1 без дообучения.
Масштаб как новая парадигма
Ключевой сдвиг последних лет — переход от отдельных контроллеров для каждого навыка к универсальным моделям, обученным на масштабных данных.
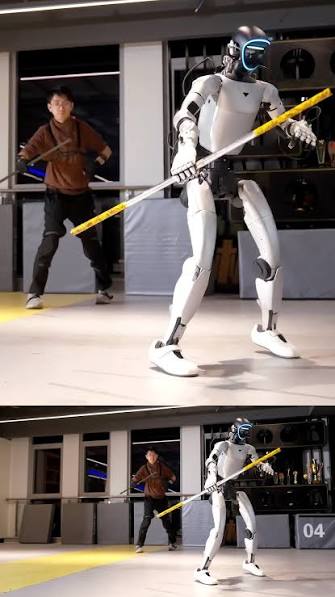
NVIDIA SONIC (Supersizing Motion Tracking for Natural Humanoid Whole-Body Control) использует более 100 миллионов кадров захвата движения — около 700 часов человеческого движения — для создания единой модели управления роботами. Одна политика ведёт ходьбу, бег, ползание, танцы и манипуляцию объектами; управлять ею можно через VR, видео или VLA-модели, а на поведение, не виденное при обучении, модель обобщается. В тестах SONIC выполнял кунг-фу и ползал по полу, копируя человека в реальном времени.
Благодаря открытости SONIC её интегрировала в платформу Walker S2 для промышленного производства робототехническая компания UBTECH. Инженеры UBTECH попутно выявили системную проблему: с ростом числа итераций обучения время, затрачиваемое вне основного цикла, растёт и снижает эффективность тренировки. Масштабирование упирается не только в алгоритмы, но и в инфраструктуру.
Открытые датасеты растут параллельно. Noitom выпустила HiPHI — 617,5 часа высокоточного оптического захвата движения, включая 371,8 часа движений всего тела и 245,7 часа взаимодействия человека с 40 физическими объектами.
Что остаётся сложным
Несмотря на прогресс, ряд проблем не решён. Контактно-насыщенные взаимодействия и сильно ограниченные движения остаются особенно трудными — особенно там, где сказывается разрыв между симуляцией и реальностью. SONIC, ZEST и другие системы — всё ещё исследовательские платформы, а не готовые продукты. Безопасность, энергоэффективность и долговечность при выполнении динамичных движений на реальном железе требуют дальнейшей работы.
Траектория развития, впрочем, ясна: захват движения перестаёт быть просто инструментом записи и становится фундаментальным интерфейсом между биологической и роботизированной моторикой. Чем больше человеческого движения удаётся зафиксировать и корректно перенести на робота, тем шире его репертуар навыков — и тем ближе момент, когда человекоподобные роботы станут по-настоящему полезными в реальном мире.
- Робот учится у человека: записи mocap, видео и анимация дешевле и безопаснее, чем сбор демонстраций на самом роботе.
- Качество ретаргетинга решает: артефакты в эталонных траекториях напрямую снижают робастность итоговой политики.
- RL не копирует, а адаптирует: ZEST переносит навыки с разных источников без дообучения, SoftMimic учит робота гасить возмущения.
- Масштаб — новая парадигма: одна политика NVIDIA SONIC на 100 млн кадров заменяет отдельные контроллеры под каждый навык.
Открыть Tric Motion
Бесплатно · Без подписки · Без карты