Представьте романтическую историю, в которой нет людей. Вообще. Человечество давно вымерло, Земля медленно оттаивает после ядерной зимы, а по волнам дрейфует одинокий буй. Он выходит на связь со спутником на орбите, и между двумя машинами начинается нечто вроде любви. Это не синопсис короткометражки — это полнометражный фильм Love Me с Кристен Стюарт и Стивеном Ёном, вышедший в прокат в 2025 году.
Но для нас интереснее другое. Love Me — один из самых показательных примеров того, что происходит, когда инди-команда без голливудской инфраструктуры берётся за фильм, который технически требует голливудского пайплайна: персонажи-машины, цифровые аватары и VFX на каждом втором кадре. Разобрали, как режиссёры Сэм и Энди Цукеро решили эту задачу на инерционном motion capture Xsens — и почему ни одна mocap-камера так и не была установлена.
- Love Me — артхаусный sci-fi о двух ИИ (буй и спутник), озвученных Кристен Стюарт и Стивеном Ёном; премьера — Sundance 2024, прокат — Bleecker Street 2025
- Герои проходят три фазы — от машин к аватарам и к человеческому облику, и каждая фаза требует своего продакшн-подхода
- Оптический mocap команда отклонила ещё на этапе исследования: для интимных сцен он был «слишком обструктивен»
- Инерционный Xsens не требует камер, освещения и студии: актёры играют в любом пространстве, а данные сразу попадают в софт
- Маленькая команда без VFX-супервайзера на площадке получила анимацию уровня крупных голливудских проектов — за заметно меньшее время
«Love Me»: роман буя и спутника
Действие Love Me происходит в будущем, где людей больше нет, а Земля оправляется от ядерной зимы. Буй и спутник случайно пересекаются, начинают переписываться и через уцелевшие архивы интернета изучают, какой была человеческая жизнь до катастрофы. Чем больше машины узнают о людях, тем сильнее хотят быть на них похожими — вплоть до того, что берут за образец популярный дуэт влогеров: создают собственные аватары и постепенно «дорастают» до человеческого облика.
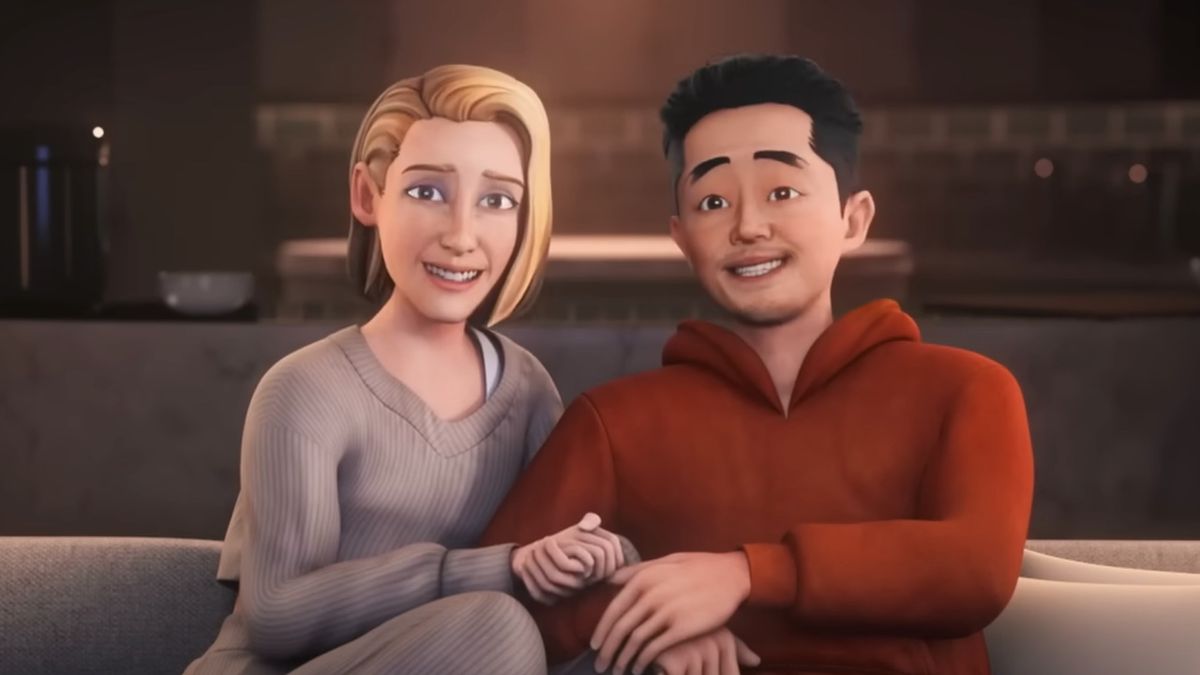
Фильм придумали и сняли Сэм и Энди Цукеро — дуэт, который взял на себя почти все этапы производства: от сценария и режиссуры до продюсирования. Роли машин озвучивают номинированная на «Оскар» Кристен Стюарт и Стивен Ён. Задача у команды была нетривиальная: превратить две говорящие железяки в героев, за чьей эволюцией зритель следит с живым интересом. И сделать это так, чтобы «очеловечивание» машин происходило прямо на экране.
Именно здесь проходит главный технический рубеж: три фазы существования героев требуют трёх разных способов производства.
Фаза первая — машины: настоящие пропсы вместо CGI
Первый этап продакшна — съёмка «нативных» кадров, которые позже VFX превращает в постапокалиптические пейзажи. Съёмочная группа объехала Северную Америку в поисках подходящих локаций, а самих героев — буй и спутник — снимали как реальные объекты.
«Мы снимали буй и спутник как настоящие пропсы, чтобы дать персонажам реалистичное, грубое ощущение», — объясняет Сэм Цукеро. Никакой графики ради графики: физический объект в кадре — это фактура, свет и поведение в среде, которые цифра по-прежнему подделывает с трудом.
Фаза вторая — аватары: сцена с актёрами в конце 2021 года
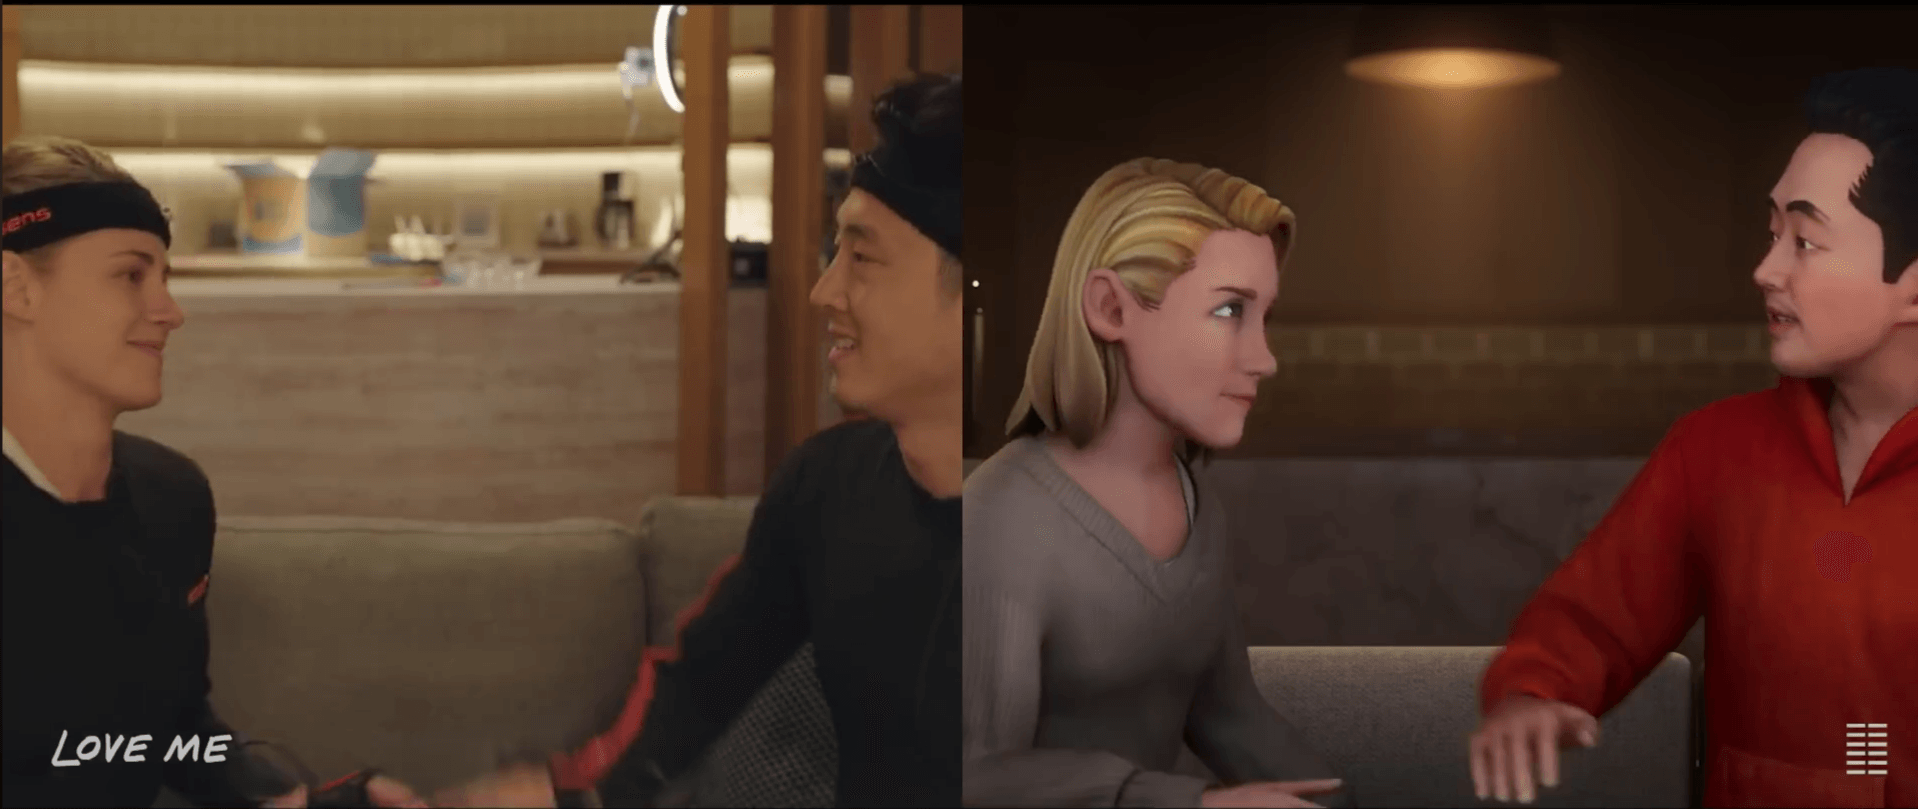
Когда герои «переселяются» в интернет и обретают тела влогеров-аватаров, в игру вступает motion capture. Первые сцены со Стюарт и Ёном записывались методом захвата движения в конце 2021 года.
Фаза третья — люди: анимация, которая не выдаёт своё происхождение
Финальная стадия эволюции героев — человеческий облик. Здесь вопрос уже не в том, «как сделать цифрового персонажа», а в том, как сохранить в нём живого актёра: его пластику, интонации тела, все мелкие привычки, из которых складывается узнаваемый человек.
Почему оптический mocap отпал до начала съёмок
До продакшна Цукеро исследовали доступные системы захвата движения. Критерий был жёсткий: эффективность без компромисса по качеству. И оптический вариант — казалось бы, индустриальный стандарт — из гонки выбыл быстро.
«Мы поняли, что оптический motion capture будет слишком обструктивным, поэтому система Xsens стала лучшим вариантом», — говорит Сэм.
Требует большого пространства с выверенным освещением, костюма с маркерами и десятков камер, следящих за актёром. Любое перекрытие маркера — сбой трекинга, настройка сцены — часы работы. Для интимных, камерных сцен, которые снимала команда Цукеро, это тяжёлая артиллерия, которая мешает, а не помогает.
Костюм или набор датчиков, которые крепятся прямо на тело и фиксируют вращение суставов, скорость и положение сегментов. Данные мгновенно уходят в программное обеспечение — камеры не нужны в принципе. Надел, откалибровал, сыграл: съёмка возможна где угодно, без специально подготовленного павильона.
Xsens — инерционная технология: миниатюрные датчики (IMU) на теле актёра сами вычисляют движение, а не «выслеживаются» камерами, как маркеры в оптике. Именно поэтому ей не нужны ни студия, ни контроль освещения, ни расстановка камер — достаточно костюма и актёра, готового работать.
Выбор между оптикой и инерциалкой здесь — не спор о том, «что лучше вообще». Оптика незаменима там, где нужна субмиллиметровая точность и сложные взаимодействия с объектами. Но для фильма, где важнее интимность и скорость, утяжелённый оптический пайплайн становился не инструментом, а ограничением: он диктует, где и как можно снимать, а Цукеро хотели, чтобы актёры просто играли.
Что инерция даёт перформансу: «видно каждое движение»
Решение в пользу Xsens принесло не только мобильность — оно изменило качество самого перформанса. Инерционный захват пишет не «позы», а поведение тела целиком: каждую особенность пластики, каждый микро-жест, который обычно теряется при маркерной очистке.
«Благодаря такому типу захвата движения зритель видит каждую особенность и крошечное движение актёра», — поясняет Энди Цукеро. Это критично для сцен, где персонажи визуально не похожи на исполнителей: даже если зритель не узнаёт в аватаре Стюарт или Ёна, язык тела считывается безошибочно. Именно он делает героев «настоящими» и держит эмоциональный контакт с залом.
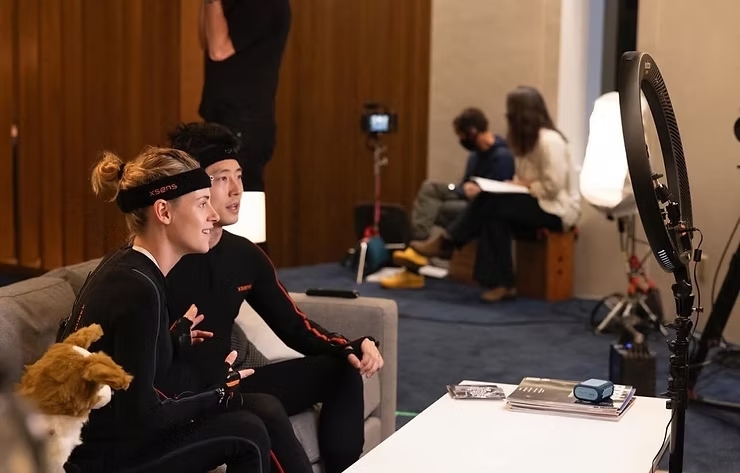
Сам процесс съёмки при этом остаётся максимально простым для актёра. Сэм описывает его так: включаешь оборудование — и артист работает, не дожидаясь, пока выставят свет и камеры. Никакой технической паузы между дублями, никакого «замри, пока перенастроим сцену».
С точки зрения режиссёра, это ещё и прямой канал передачи актёрского замысла в анимацию: намерения исполнителя не «пересказываются» аниматором по видео-референсу, а переносятся в цифрового персонажа напрямую, вместе с телом. Для фильма, где герои половину хронометража существуют как аватары, это решающее преимущество.
Маленькая команда, большие идеи
Love Me — фильм независимый, и инфраструктура у него соответствующая: никакого супервайзера VFX, дежурящего на площадке. Всю тяжесть работы команда несла сама — от натурных съёмок с пропсами до mocap-сцен с актёрами. И именно простота развёртывания Xsens позволяла не превращать каждый съёмочный день в технический квест: надел костюм, сделал движения, посмотрел данные. Правки вносились быстро и с высокой точностью, без долгих циклов пересъёмки.
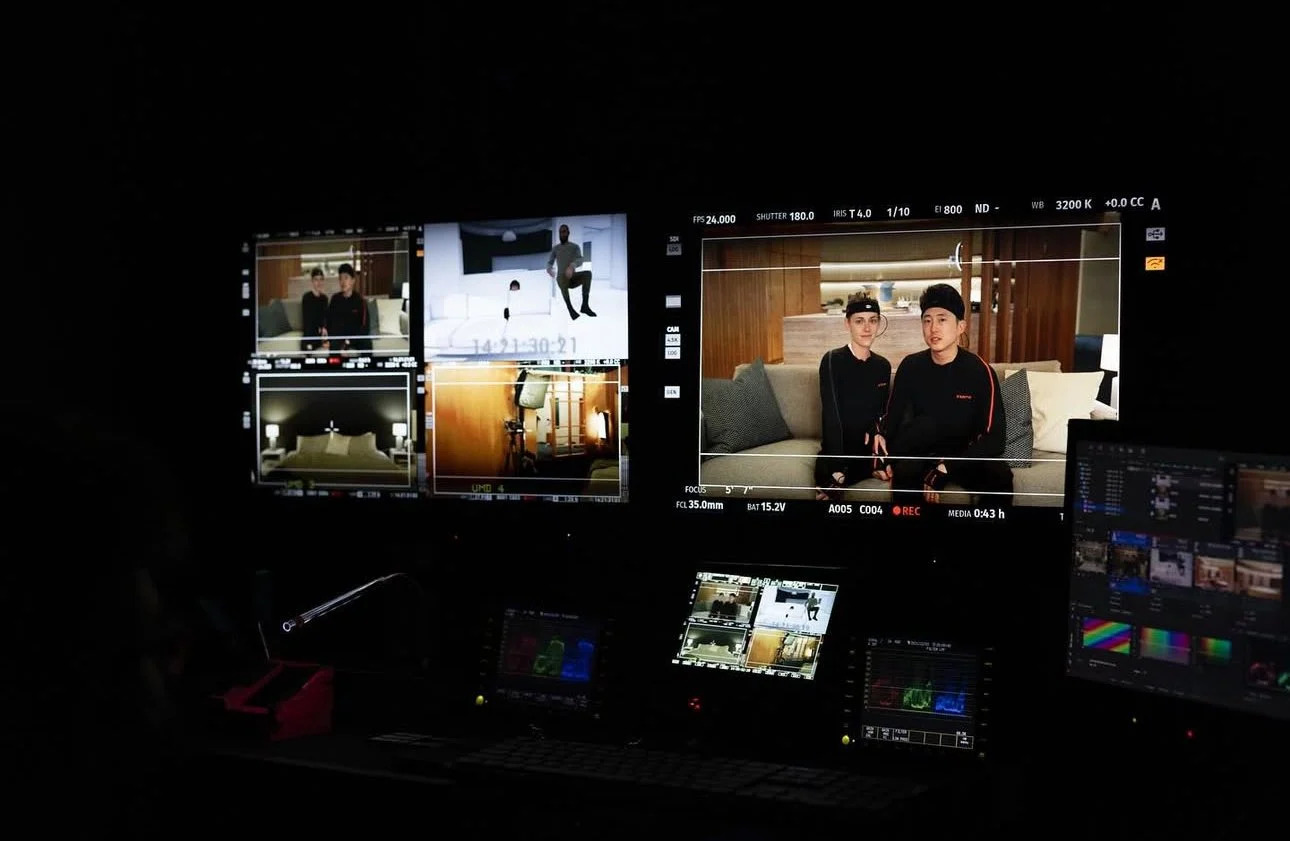
Результат не заставил себя ждать: в январе 2024 года фильм впервые показали на фестивале Sundance, а в 2025-м его выпустила в прокат компания Bleecker Street. Love Me — редкий пример удачного смешения романтики и sci-fi, где технологии не подменяют эмоции, а работают на них.
«С точки зрения актёра, было удивительно, что намерения исполнителя можно включить в работу и увидеть, как они транслируются даже сквозь анимацию», — вспоминает Сэм.
Энди вторит ему: «Мы действительно оценили, как просто было реализовывать наши идеи с помощью Xsens». Вместе с командой они довели фильм до финиша с качеством, сопоставимым с крупными голливудскими постановками, — но за долю времени, которую такие проекты обычно тратят только на подготовку захвата.
Что забираем из кейса Love Me
История Love Me показательна не голливудским размахом, а его отсутствием. Фильм, герои которого — две машины, а половина экранного времени — анимация, снят командой без mocap-студии, без оптического парка и без профильного супервайзера. Всё, что понадобилось, — инерционные костюмы Xsens, актёры и готовность импровизировать.
Если собрать кейс в практический вывод, получается простой критерий выбора:
- Съёмка в любом месте, быстрый развёртывание, живые импровизации актёров — инерционный mocap: он не привязывает продакшн к павильону и не встаёт между режиссёром и исполнителем.
- Субмиллиметровая точность, сложные взаимодействия с предметами, жёсткие требования к геометрии сцены — оптика остаётся вне конкуренции, и никакой инерциальный костюм её здесь не заменит.
Love Me доказывает вторую, менее очевидную вещь: mocap — это не только про «качество данных», но и про то, как технология влияет на актёрскую игру. Когда оборудование не мешает, исполнители работают свободнее — и именно эта свобода в итоге видна на экране. Если хотите глубже разобраться в том, чем инерциальные системы отличаются от оптических и как из них выжать максимум, — почитайте наш обзор инерционного motion capture Xsens и гайд по настройке.